Auditoría y retención
Cada petición que pasa por el proxy deja una fila, y cada acción del plano de control deja un evento. Aquí ves cómo buscarlos en «Auditoría», cómo los resume «Operativa», cómo cruzarlos con la auditoría nativa del cluster y cuánto tiempo se guardan.
Buscar peticiones a los clusters
- Abre «Auditoría». La pestaña «Peticiones a los clusters» está seleccionada.
-
La barra de encima de la tabla mantiene a la vista las cuatro preguntas de un incidente: quién («Cuenta»), dónde («Cluster»), cuándo («Periodo») y cómo acabó («Resultado»). «Cuenta» y «Cluster» son selectores; «Periodo» y «Resultado» son chips, y volver a pulsar el chip activo lo apaga. El resto está tras «Más filtros»:
Filtro Qué acota «Cuenta» Una persona o un bot. «Cluster» Un cluster. «Periodo» «1 h», «24 h», «7 d», «30 d» o «Personalizado». Solo «Personalizado» muestra «Desde» y «Hasta». «Resultado» «Todo»; «Denegadas» ( 401y403); «Fallidas» (5xx, o un error después de un estado de éxito, como un stream que el cluster cortó); «Escrituras» (create,update,patch,deleteydeletecollection, y tambiénexec,attachyport-forward).«Entorno» «Todos», «Producción» (todos los entornos marcados como producción) o un entorno: las peticiones de los clusters que tiene hoy. Un cluster que cambia de entorno se lleva sus peticiones anteriores, porque el filtro mira dónde está ahora, no dónde estaba cuando se hizo la petición. «Prefijo de la credencial» El prefijo klt_…de una credencial (lo ves en «Credenciales»). Puedes pegar el token completo: solo se conservan sus primeros 12 caracteres.«Namespace» Un namespace exacto. «Verbo» Uno a la vez, en tres familias: «Lectura» ( get,list), «Escritura» (create,update,patch,delete,deletecollection) y «Stream» (watch,proxy).«Recurso» Por ejemplo podsosecrets.«Herramienta», «Sesión de agente» Las peticiones de un agente de IA: ver Agentes de IA. «Comando» El comando que pidió la petición, tal como lo declara kubectl, sin kubectlni argumentos:get,apply,rollout restart. Solo casa con filas hechas con kubectl (ver De dónde sale el comando).«Incluir descubrimiento» Muestra también las filas sin recurso. -
Pulsa «Buscar», o «Aplicar» dentro de «Más filtros». Los resultados van de 50 en 50, del más reciente al más antiguo.
No se busca nada hasta que pulsas «Buscar», «Aplicar» dentro de «Más filtros» o «Aplicar» junto a «cambios sin aplicar»: elegir una cuenta o pulsar un chip solo edita un borrador. Si cierras «Más filtros» de otra manera, conserva lo que elegiste, y la frase de encima de la tabla añade «cambios sin aplicar» hasta que lo aplicas. «Restablecer», dentro de «Más filtros», vacía sus campos, no los cuatro de la barra, y no aplica nada hasta que pulsas «Aplicar». Una vez aplicados, el botón «Más filtros» muestra cuántos de sus filtros están en uso.
Los filtros, la página y la pestaña viven en la URL de la página, así que un enlace a una investigación la reproduce para quien lo abra; una frase encima de la tabla dice qué está aplicado (por ejemplo «Peticiones denegadas de deploy-bot, en kind-local, últimas 24 h»), con un botón «Limpiar» al lado. Al paginar un periodo relativo, el final de la ventana se mantiene fijo (la frase añade «hasta el …», el paginador dice «instantánea de las …» y la URL lo guarda como until), mientras que «Buscar» vuelve a la página 1 con una ventana que termina ahora.
Encima de la barra, cinco cifras cuentan lo que seleccionan los filtros aplicados: «Peticiones», «Denegadas», «Fallidas», «Escrituras» y «Llamadas de agentes» (peticiones que un agente de IA hizo con una herramienta MCP). «Denegadas», «Fallidas» y «Escrituras» cuentan exactamente lo que dejan los chips del mismo nombre en «Resultado»; las cifras solo se leen, así que para ver esas filas pulsa el chip y «Buscar». Debajo, una minigráfica dibuja las peticiones por hora del periodo (por día UTC a partir de 48 horas), con la parte denegada al pie de cada columna en rojo; pasa el puntero sobre una columna para leer su hora y sus cifras, y la línea de debajo da el periodo y su máximo. Sin periodo elegido, la tabla lista todas las peticiones, pero las cifras cuentan las últimas 24 horas, como dice esa línea. En Free, las cifras empiezan donde empiezan las 24 horas de auditoría. GET /api/audit/summary da los mismos recuentos: API.
Un enlace puede acotar la lista a un acceso sensible con ?access= en la URL, como hacen las cifras de accesos sensibles de «Inicio»: exec (los subrecursos exec y attach), secrets (get, list y watch sobre Secrets) o portforward. Cuentan igual las peticiones permitidas y las denegadas, así que una cifra y la lista que abre enseñan las mismas filas. Ningún campo de la barra lo pone: la frase de encima de la tabla lo nombra («Solo exec y attach») y su botón «Quitar filtro» lo quita y conserva el resto de la búsqueda.
En cuanto un entorno se marca como producción, la línea de accesos sensibles de «Inicio» cuenta solo los clusters de producción y lo dice («Accesos sensibles en producción»). Sus enlaces añaden production=true a la dirección, que pone «Producción» en «Entorno», así que cada cifra sigue siendo el número de filas de la lista que abre. ?environment= toma en su lugar el id de un entorno; pedir los dos a la vez, o un entorno que no existe, es un error. «Producción» no enseña nada mientras ningún entorno esté marcado como producción.
Por defecto se ocultan las filas sin recurso: el descubrimiento (/api, /apis, /version, /openapi), que kubectl hace en cada comando, y también las peticiones que kubelatch rechaza antes de llegar al cluster. Entre ellas están los fallos de autenticación (sin token, token desconocido, revocado o caducado, el 401) y los 403 de cuenta deshabilitada, credencial de otro cluster o sin permisos. Para verlas, abre «Más filtros», marca «Incluir descubrimiento» y pulsa «Aplicar».
Las filas de un 401 no tienen cuenta, solo el prefijo del token: no salen si filtras por «Cuenta», y la persona dueña del token no las ve en su «Mi actividad». Búscalas por fecha, cluster o el «Prefijo de la credencial», que siempre incluye las filas de descubrimiento (no hace falta marcar también «Incluir descubrimiento»).
Una persona sin rol de admin ve sus propias filas en «Mi actividad», que se abre desde «Ver toda mi actividad» en la tarjeta «Actividad reciente» de «Inicio»: Mi actividad.
Qué tiene cada fila
Las filas se agrupan bajo un encabezado con su día («Hoy», o la fecha). La tabla muestra la hora al segundo (con el cursor encima, la fecha completa), cuenta, cluster, «Qué», estado y duración. «Qué» es una línea, verbo recurso/nombre (namespace): exec pods/web (default), delete pods/web-7f9c (shop) o descubrimiento /api; en una petición que hizo un agente de IA le sigue, atenuado, un vía apply, con la herramienta. En una petición hecha con kubectl le sigue, igual de atenuado, el comando que la pidió, sin el nombre de la herramienta: patch deployments/api (shop) seguido de «vía rollout restart». Cuando el comando es la misma palabra que la acción (delete y «vía delete») no se repite. El estado es una píldora con el código de respuesta, teñida según el resultado, con el error en una línea debajo.
Las peticiones idénticas seguidas se pliegan en una sola fila: la misma cuenta, credencial, cluster, acción, objeto, estado, error e IP de origen, con 5 s como mucho entre una y otra y en el mismo día. La fila lleva un botón «× 12» que despliega el resto. Un fallo entre dos éxitos, o otra credencial u otra dirección, nunca se pliega bajo un éxito, y solo se pliega la página que estás viendo. En una pantalla estrecha la tabla es una lista, con un elemento por petición o por pliegue.
Las peticiones de una misma ejecución de kubectl se pliegan también, estén seguidas o no: un kubectl apply -f dir/ con treinta objetos es una sola fila que lee su petición principal como cualquier otra, patch configmaps/feature-flags (apps) seguido de «vía apply», y después «+29 escrituras» y un botón «62 peticiones» que las despliega. La petición principal es la última escritura (si no hubo ninguna, la última petición); el estado es el peor de todas, así que una denegación dentro de un apply nunca queda escondida bajo un 200; la duración va de la primera a la última. Solo se pliegan las peticiones de la misma credencial en el mismo cluster, y solo dentro de la página que estás viendo. Pulsar la fila, o su «Qué», abre el detalle de la petición principal.
Pulsa en cualquier punto de una fila, o en su «Qué», para abrir el «Detalle de la petición» en un panel a la derecha. El menú de la fila trae los pivotes del pie del panel («Solo esta cuenta», «Solo este cluster», «Solo esta credencial», «Solo esta sesión») y «Abrir». El panel se abre sobre su título y una frase que dice la petición, por ejemplo «deploy-bot modificó configmaps/feature-flags en apps (kind-local) · 201 · 2 ms · vía apply». «Audit-ID» y «Petición» son campos que se copian, y la «Cuenta», el «Cluster» y la «Sesión de agente» que nombra son enlaces a sus páginas. Los demás campos:
| Campo | Qué es |
|---|---|
| «Audit-ID» | El id de la fila. Es el mismo que recibe el cluster. |
| «Credencial» | Su nombre, con un enlace a «Credenciales», y el prefijo klt_…. Si esa página no la lista (una eliminada, o la de un agente de IA), muestra su id tal cual. En un fallo de autenticación, solo el prefijo con «(rechazada)». |
| «Petición» | Método, ruta y query string. En un exec, la query lleva el command=: lo que la persona tecleó. |
| «Verbo / grupo / versión» | Cómo lo interpreta Kubernetes. |
| «Entró como» | El usuario que el proxy mandó al cluster en nombre del sujeto (Impersonate-User), tal como lo nombró la plantilla de identidad del cluster: user:<login> por defecto, y siempre para un agente de IA delegado. Vacío en una petición rechazada antes de calcular el nombre. |
| «Grupos suplantados» | Los grupos kubelatch:… con los que el proxy actuó en nombre del sujeto, dichos con palabras (developer en apps, developer en todo el cluster); con el cursor encima, el nombre en bruto. Los grupos de un rol nativo salen tal como los nombra el cluster. |
| «IP de origen», «User-Agent» | De dónde vino. Detrás de un Ingress depende de KUBELATCH_TRUSTED_PROXIES (Instalar). |
| «Herramienta MCP», «Sesión de agente» | En una petición que hizo un agente de IA por el servidor MCP: la herramienta y la sesión del agente. Vacías en todo lo demás. |
| «Comando», «Sesión» | En una petición hecha con kubectl: el comando que la pidió, sin argumentos (rollout restart), y el identificador de esa ejecución, el mismo en todas sus peticiones. Vacíos en todo lo demás. |
| «Stream (upgrade)» | Si fue un upgrade SPDY o WebSocket. |
| «Estado», «Duración», «Fin», «Error» | Se completan al terminar. Un stream abierto sale «En curso». |
Al pie del panel, unos botones pivotan la investigación: «Solo esta cuenta», «Solo este cluster» y «Solo esta credencial» acotan la búsqueda que tenías a esa sola cosa (su periodo y su resultado se mantienen) y vuelven a la tabla; «Solo esta credencial» trae además las filas de descubrimiento, para que un intento rechazado no desaparezca. «Solo esta sesión» (solo en una petición hecha con kubectl) acota a las peticiones de esa ejecución, con sus filas de descubrimiento. «Revocar esta credencial» (solo mientras la credencial sigue activa) pide confirmación y un motivo opcional y la revoca al instante, igual que desde «Credenciales».
Estados que conviene reconocer:
499conclient disconnected: el cliente colgó antes de recibir respuesta, por ejemplo un Ctrl-C.403constream cut…: una revocación (de credencial, cuenta o permiso) cortó el stream antes de que el cluster respondiera. Si ya estaba abierto, la fila conserva101o200con ese mismo error.- Un stream cortado por un reinicio de kubelatch termina con el error
kubelatch restarting.
Los fallos de autenticación se registran como mucho una vez por IP cada 10 s. Los 400 de política del proxy (rutas con .. o %, cabeceras Impersonate-*) no dejan fila, pero la respuesta lleva igualmente la cabecera Audit-ID.
exec, attach y port-forward
Se reconocen por el subrecurso, no por el verbo. kubectl usa get por WebSocket y create por SPDY para la misma acción. «Qué» ya lo traduce: exec, attach, port-forward o logs.
Para encontrarlos, pulsa «Escrituras» en «Resultado», que cuenta exec, attach y port-forward como escrituras, y filtra por «Recurso» pods en «Más filtros». El filtro «Verbo» no sirve para esto.
De dónde sale el comando
kubectl añade a cada petición dos cabeceras, Kubectl-Command y Kubectl-Session: el comando sin argumentos (kubectl rollout restart) y un identificador por ejecución, el mismo en todas las peticiones de un mismo kubectl …. Las envía por defecto desde la versión 1.22 y siempre desde la 1.35; con una versión entre la 1.22 y la 1.34, KUBECTL_COMMAND_HEADERS=false en el entorno de quien ejecuta kubectl las apaga. kubelatch las guarda con la fila, sin la palabra kubectl en pantalla, y las usa para decir «vía rollout restart» y para plegar las peticiones de una ejecución.
No las mandan helm, k9s, Lens, Argo CD, Flux, Terraform, los plugins kubectl-* (krew incluido) ni lo que pasa por kubectl proxy: sus filas no llevan comando y se leen como hasta ahora, con su «User-Agent». La cabecera nunca trae argumentos, nombres de recursos, ficheros ni valores de flags; eso lo da la propia petición, como siempre.
El comando lo declara el cliente: cualquiera puede enviar otro o ninguno. kubelatch lo guarda tal cual (descarta lo que no tenga la forma de un comando o de un identificador) y no decide nada por él: ni permisos, ni aprobaciones, ni filtros de seguridad. Es una etiqueta para leer la auditoría, no una prueba de lo que se ejecutó; la prueba es la petición.
Cruzar con la auditoría nativa del cluster
Toda respuesta del proxy, también los errores, lleva la cabecera Audit-ID (kubectl -v=8 la muestra). Es el id de la fila y el mismo auditID que el API server escribe en su propio log de auditoría.
- Copia el «Audit-ID» del detalle de la fila.
- Búscalo en la auditoría nativa de tu proveedor (CloudWatch en EKS, Cloud Logging en GKE, Azure Monitor en AKS) o en el fichero de auditoría del API server.
Mantén activa la auditoría nativa del proveedor. Lo que se hace con un token de ServiceAccount obtenido desde un pod no pasa por kubelatch y solo queda ahí.
Agentes de IA
Cada petición que un agente de IA envía a un cluster es una fila como cualquier otra, con dos campos más: la herramienta y la sesión de agente. En «Más filtros», «Herramienta» y «Sesión de agente» reducen la tabla a una herramienta o a un agente, y «Qué» termina con el vía atenuado y la herramienta. Las filas de un agente delegado tienen a su persona como sujeto: filtra por «Sesión de agente» para distinguirlas de los kubectl de la propia persona. Las filas de las llamadas de una sesión están también en su página de «Agentes», en «Línea de tiempo», agrupadas por llamada, donde las ve también su dueño.
read_secretdeja una fila por llamada: cada lectura de los valores de un Secret queda registrada.- Una escritura retenida para aprobar deja una fila por su vista previa y otra por su dry run; la ejecución aprobada es una tercera fila. La página de la solicitud dice cuándo se ejecutó y qué respondió el cluster.
whoamiyrequest_accessno llegan a ningún cluster y no dejan fila aquí. Las sesiones y las solicitudes están en el plano de control:agent.session.start,agent.request.createy las demás, más abajo.- Las solicitudes cerradas se guardan lo mismo que las filas de aquí (
KUBELATCH_AUDIT_RETENTION); el cuerpo de una escritura retenida se borra en cuanto se deniega, se ejecuta o caduca.
El plano de control
La pestaña «Plano de control» lista cada acción de administración y cada intento de login, uno por fila bajo un encabezado con su día, en columnas fijas: «Hora», «Cuenta», «Qué», «Objetivo» e «IP».
- «Qué» es una frase construida con los datos del evento, por ejemplo
Credencial «laptop» de «ux-dev» revocada: «perdida»oAlta de «ana» en el grupo «ops», sin caducidad. Una acción que kubelatch no reconoce muestra solo su código en bruto. - «Cuenta» es el actor, por su login cuando es una cuenta conocida. Las acciones sin actor aparecen como «CLI del servidor (kubelatch-server)» cuando vienen de
kubelatch-server user …, y como «Sistema o anónimo» en los demás casos: las bajas automáticas de GitHub, los intentos de login fallidos con un login desconocido, un acceso con OIDC fallido, un canje de CI fallido. - «Objetivo» dice su tipo con palabras (Cuenta, Permiso, Credencial, Grupo…) y enlaza a la página de la cuenta, de los permisos de la cuenta, del cluster, del grupo, del rol, de la credencial, de la sesión de agente o de la solicitud mientras exista. Si se eliminó, queda como texto atenuado seguido de «eliminado» («eliminada» en femenino), sin enlace; una solicitud se lee así cuando su cluster ya no está. La credencial de un agente de IA es texto sin enlace, porque «Credenciales» no la lista.
- Pulsa la frase, o cualquier punto de la fila, para abrir el «Detalle del evento» en un panel: la frase, «Fecha», «Cuenta», «Acción» (con palabras, con su código en bruto al lado; un enlace de cuenta usado se lee según su propósito: invitación, restablecimiento o vinculación con GitHub o con el proveedor OIDC), «Objetivo» e «IP». «Ver JSON» despliega el dato en bruto del evento (
reason,via, …). - Un cambio hecho sobre varios elementos a la vez (varios permisos concedidos, revocados o ampliados, miembros quitados o ampliados, aprobaciones y solicitudes de acceso decididas o sesiones de agente cortadas) se ve en una línea mientras dos o más de sus filas están juntas en la página: quién lo hizo, qué hizo y a cuántos (
ana revocó 37 permisos), los cambios derivados que causó a través de los grupos (y 12 cambios derivados) y su motivo en texto atenuado. «N filas» abre una fila por elemento, cada una con su detalle. Cada fila del lote llevabatch(el id que comparte el lote),batch_sizey, si se dio,reason; un elemento que ya estaba revocado o quitado llevaunchanged: true. - Guardar un entorno, o el entorno y las etiquetas de un cluster, también se ve en una línea cuando recorta permisos, con las filas recortadas debajo:
ana guardó el entorno prod y recortó 3 permisosoana movió el cluster eu-2 a prod y recortó 2 permisos. La cifra son los permisos que recortó el guardado; las filas de los miembros de un grupo siguen al permiso del grupo. La frase de cada fila recortada termina conrecortado por la regla de prod. Cuando el guardado también quitó o dio permisos sobre un conjunto, la frase de su fila añade «, quitó N y dio M permisos sobre un conjunto». - Un permiso sobre un conjunto se lee
Permiso viewer sobre staging concedido a «alice», y lo mismo al revocarlo o ampliarlo. «Volver a comprobar» se lee «Volver a comprobar staging: llega a N más». El permiso que ese conjunto pone en cada cluster tiene su propia fila, y su frase termina con «vía staging».
La barra tiene «Cuenta» (el actor), «Acción», «Cluster» y «Periodo», y «Buscar». «Acción» abre una lista agrupada por familias en la que puedes buscar por sus palabras o por el código, y «Todas las acciones» la vacía. «Cluster» deja los eventos de un cluster: los suyos y los de los permisos que hay en él, los mismos que enseña «Cambios» en la página del cluster. No se busca nada hasta que pulsas «Buscar» (o «Aplicar» junto a «cambios sin aplicar»). Los filtros y la página quedan guardados en la URL de la página para poder compartir o guardar una búsqueda, igual que en «Peticiones a los clusters», y la frase de encima de la tabla dice qué está aplicado, con su «Limpiar».
Códigos de acción, por área:
| Área | Códigos |
|---|---|
| Inicio de sesión | login.success, login.failure (con reason, por ejemplo password_disabled; un acceso con GitHub u OIDC lleva via: github u oidc, y el acceso de un enrolamiento con una identidad, kind: bootstrap), logout, user.logout (sesión cerrada por un administrador), cli.login, cli.approve, cli.deny |
| Agentes de IA | agent.session.start (primera vez que la credencial de un bot se usa a través del servidor MCP, details lleva la credencial y el cliente; o una persona autorizó a un agente a actuar en su nombre, details lleva el cliente y cada permiso que recibió), agent.session.revoke (una sesión cortada, con la credencial del bot que se revocó; kubelatch corta por sí mismo una sesión delegada, sin actor, cuando su cliente presenta por segunda vez un refresh token o un código, o cuando la limpieza de cada hora encuentra que el código que aprobaste nunca se canjeó (authorization code never exchanged), details.reason; un corte de varias sesiones a la vez lleva batch, el id que comparte ese lote, y batch_size), agent.request.create (un agente dejó una solicitud de escritura o de acceso para una persona; el actor es el bot), agent.request.approve y agent.request.deny (la decisión de una persona; un acceso aprobado lleva su permiso nuevo en details; una decisión tomada sobre varias a la vez lleva batch, el id que comparte ese lote, y batch_size), agent.grant.follow (un permiso que una persona recibió después de autorizar a un agente llegó a su sesión: el actor es quien lo concedió, el objetivo la sesión, y details lleva el permiso nuevo, su permiso padre, el cluster, el ámbito, los dos roles y el follow de la sesión: viewer o same), agent.approval_setting.change (el interruptor «Las escrituras piden aprobación» de un bot, antes y después), oauth.client.register (el cliente de un agente se registró para iniciar sesión en nombre de alguien, o kubelatch leyó por primera vez el documento de metadatos de uno que se identifica con su URL, entonces con details.origin cimd y el host del documento; sin actor, details lleva su nombre y sus URIs de redirección) |
| Cuentas | user.create (via dice cómo se creó la persona: cli desde la CLI del servidor, domain por una regla de dominio, con su domain, join por una solicitud de alta aprobada, con su request_id; sin via, desde «Usuarios»), bot.create, user.update (un cambio del perfil: display_name, email y la dirección anterior, previous_email, is_admin y was_admin), user.disable, user.enable, bot.disable, bot.enable, user.break_glass, user.locale, user.notifications (la persona encendió o apagó el correo antes de que caduque un permiso: before y after), password.set, password.change, link.reset, link.email_sent, link.email_failed, link.complete, github.link, github.unlink, oidc.link (una identidad OIDC vinculada: via es email, en un primer acceso, me, desde «Mi cuenta», domain, en un alta por dominio, o join, por una solicitud de alta aprobada), oidc.unlink (un administrador la desvinculó), oidc.email_changed (el proveedor envió una dirección de correo nueva para la identidad: from y to), account_link.revoke (un administrador cambió o quitó el correo de una cuenta cuya invitación o enlace de restablecimiento pendiente salió por correo: reason es email_changed y count cuántos anuló), mail.test (un administrador se envió el correo de prueba: to_domain, el dominio de la dirección, result, sent o failed, y si falla, el status de Resend y el name de su error) |
| Clusters | cluster.create, cluster.enrollment.create (un comando de enrolamiento o, con method: identity, un enrolamiento con la identidad de un administrador: su api_url, rotate, expires_at y de dónde salió la CA, ca_source, pasted o in_cluster), cluster.enrollment.revoke (con method: identity y reason oidc.<código> cuando ese acceso no terminó), cluster.bootstrap (uno por intento de un enrolamiento con una identidad que llegó al API server, con via: identity y su outcome: applied, token_rejected, untrusted_certificate, version, forbidden, apply_failed, tokens_timeout, tokens_invalid o internal; el issuer, el subject y el email verificados, cómo lo vio el API server, apiserver_user y apiserver_groups, la api_url, rotate, cuántos objetos se aplicaron, applied, y, tras un fallo, su code y sus params, que nombran el objeto o el permiso; nunca un token), cluster.tokens (via: enrollment desde el comando; via: identity desde un enrolamiento con una identidad, con su issuer, su subject y su email), cluster.identity.update (se guardó la plantilla de identidad del cluster: before y after), cluster.provider.update (el proveedor del cluster, fijado a mano o devuelto a la deducción: before y after, vacío para automático; solo se escribe cuando el valor cambia), cluster.grant.refused y cluster.grant.restored (una pasada del reconciliador vio que un permiso dejó de surtir efecto, o que vuelve a surtirlo o se revocaron sus permisos: sin actor, una vez cuando aparece el problema y otra cuando desaparece, con su code (privileged, psa_required o namespace_missing), su role y su namespace o su name, y los permisos que hay detrás), cluster.delete, cluster.placement (se guardaron el entorno y las etiquetas de un cluster: from y to, cada uno con su environment y sus labels, cut, cuántos permisos recortó, y lost y gained, cuántas veces un permiso sobre un conjunto dejó o empezó de llegar a un cluster; se escribe aunque no cambie nada), environment.create (con su marca production y sus reglas, max_ttl_seconds y default_ttl_seconds, en segundos, null para la que no tenga), environment.update (from y to, cada uno con production, max_ttl_seconds y default_ttl_seconds, cut, cuántos permisos recortó, y lost y gained, como en cluster.placement; se escribe aunque no cambie nada) y environment.delete (con los clusters que dejó sin entorno, y lost y gained); el objetivo de las tres acciones environment.* es el entorno |
| Permisos y credenciales | grant.create, grant.revoke, grant.expiry (un permiso cuya caducidad cambió, ampliada por un administrador, con su grupo o recortada por la regla de un entorno, from y to; un recorte añade reason: environment y el environment), credential.issue, credential.revoke, credential.lookup (un administrador pegó un token entero: matched dice si coincidió alguna credencial y la fila la nombra, con su kind, o no tiene destino si no coincidió ninguna; nunca el token). Los tres grant.* de un permiso derivado de un grupo llevan group_id, member_id y group_grant_id. grant.create, group.grant.create, set.grant.create y group.member.add llevan siempre el note y el ticket de la fila ("" si no hay); un permiso derivado de un grupo o de un conjunto lleva los que copió. Un grant.create hecho desde una petición lleva expiry: chosen (la petición dio una fecha), default (no dio ninguna y recibió la caducidad por defecto: 30 días, o la del entorno del cluster) o never (pidió que no caducara). El permiso que dio una solicitud de acceso lleva expiry: request y su request_id en grant.create, más policy, el entorno, cuando lo concedió su regla sin aprobación; una prórroga por solicitud escribe grant.expiry con request_id y reason: request |
| Permisos sobre un conjunto | set.grant.create (se concedió un permiso sobre un conjunto, uno por cuenta o grupo y ámbito: selector ({kind, key, value}), role, scope, subject_id o group_id, expires_at, note, ticket, expiry como en grant.create, y reached y refused, los clusters a los que llegó y a los que no), set.grant.revoke (reason es role.delete, group.delete o environment.delete cuando lo revocó una eliminación, y no hay cuando lo revocó un administrador), set.grant.expiry (from y to; un recorte por la regla de un entorno añade reason: environment y el environment) y set.grant.recheck («Volver a comprobar»: gained, los clusters que trajo, y refused, los que siguen rechazados; se escribe aunque no traiga ninguno); el objetivo de las cuatro es el permiso sobre el conjunto. Cada cluster al que llega o deja de llegar escribe su propio grant.create, grant.revoke o grant.expiry (group.grant.* en un grupo), con set_grant_id y el selector; un grant.revoke añade reason: set cuando el cluster salió del conjunto, o el code y los params del rechazo que se lo quitó. El actor es el administrador cuyo cambio los movió (el permiso, la colocación de un cluster, una regla, una eliminación); un reintento, o la edición de un rol que decide un cluster por sí sola, los deja sin actor |
| Incorporación | access_request.create (alguien sin cuenta pidió unirse: sin actor, el objetivo es la solicitud, y details lleva la dirección, el issuer y el subject del proveedor), access_request.approve (con el login creado y el access inicial: group con su group_id, grant con el permiso, o none), access_request.deny (con la note del administrador), access_request.cancel (la persona entró por otra vía, con via), signup_domain.create, signup_domain.update (la caducidad de la pertenencia, from y to en segundos), signup_domain.delete (con members_removed); el objetivo de una regla es su dominio. Un alta por dominio escribe group.member.add sin actor y con details.rule, y sus grant.create derivados con quien creó la regla como actor; quitar una regla escribe un group.member.remove por pertenencia, con rule (Acceso por dominio y solicitudes de alta) |
| Solicitudes de acceso | La solicitud de un rol de una persona escribe las mismas acciones access_request.* que una solicitud de alta, con la solicitud como objetivo y, en todos los details, subject_id, cluster_id, role y scope. access_request.create (el actor es quien pide: duration en segundos, reason, ticket, origin y origin_detail, needs_admin y, en una prórroga, extends_grant_id), access_request.approve (el actor es el administrador: as: admin, la duration concedida, granted_until, grant_id, la note y extended; la regla de un entorno la escribe sin actor, con as: policy y el environment), access_request.deny (con la note), access_request.cancel (el actor es la persona; sin actor y con cause: account_disabled cuando se deshabilitó la cuenta) y access_request.expire (sin actor: pasaron 24 horas sin decisión). Una decisión sobre varias solicitudes a la vez, también de alta, lleva batch, el id que comparte el lote, y batch_size en cada access_request.approve o access_request.deny y en el grant.create o grant.expiry de cada permiso que da |
| Dueños | owner.add y owner.remove (un administrador nombró o quitó un dueño: el objetivo es el dueño, y details lleva el scope, {"kind": "environment", "environment_id"}, {"kind": "cluster", "cluster_id"}, {"kind": "namespace", "cluster_id", "namespace"} o {"kind": "group", "group_id"}, y el owner, subject_id y login o group_id). Lo que hace un dueño sin ser administrador escribe la acción de siempre (grant.create, grant.expiry, grant.revoke, group.grant.*, group.member.*, access_request.approve, access_request.deny) con as: owner y, en owner_scope, el ámbito que le daba derecho (Dueños) |
| Grupos | group.create, group.update, group.delete (con cuántos miembros y permisos tenía, y set_grants, cuántos de ellos eran permisos sobre un conjunto), group.member.add (con note y ticket, "" si no hay), group.member.update, group.member.remove, group.grant.create (con note, ticket y expiry, como grant.create), group.grant.update (con reason: environment y el environment cuando lo recortó la regla de un entorno), group.grant.revoke; el objetivo es el grupo. Cada cambio escribe además un grant.* por cada permiso derivado que crea, revoca o amplía (Grupos) |
| Roles | role.create, role.update, role.delete (borrar un rol con revoke_grants escribe además un grant.revoke por permiso y un set.grant.revoke por cada permiso sobre un conjunto, con reason: role.delete; set_grants los cuenta); role.create y role.update llevan el kind del rol y sus groups, groups_before y groups_after al editarlo, que solo tiene un rol nativo |
| CI | ci.trust_rule.create, ci.trust_rule.delete, ci.exchange.failure |
| Edición | license.install (una clave de licencia instalada desde «Edición»: el objetivo es la licencia, y details lleva el cliente, las plazas, si es de prueba y la caducidad, nunca la clave), license.remove (la clave instalada, retirada: details.removed es true, con el cliente si la clave aún se podía leer, o false si no había clave que retirar) |
| Webhooks | webhook.create (con su nombre, formato, idioma y eventos), webhook.update (before y after, active incluido: pausar o reanudar es una actualización; url_changed dice si una dirección nueva sustituyó a la anterior), webhook.delete, webhook.test («Enviar una prueba», con el status del ping y el response_code del receptor); el objetivo es el webhook. Nombran la URL solo por su origin (https://hooks.slack.com), porque la ruta de una URL de Slack o de Teams es su credencial, y nunca guardan el secreto |
El login.success de un acceso con OIDC lleva el issuer del proveedor, la identidad (subject_claim y subject), el email y, cuando el token los trae, amr y acr, que dicen cómo se autenticó la persona en el proveedor. El login.failure de uno fallido nombra el correo cuando se conoce, y su reason es uno de los códigos de Errores del login con OIDC: ambiguous_account lista las cuentas en candidates, y oidc lleva el error del proveedor en idp_error. oidc.link lleva además cuántos enlaces pendientes revocó (invites_revoked) y, cuando sustituyó una identidad de otro proveedor, replaced_issuer o replaced_claim. Un link.complete usado con el proveedor OIDC lleva la identidad, y email_mismatch cuando el correo del proveedor no es el de la cuenta. Ningún evento guarda un token, un código ni el secreto del cliente.
El acceso con contraseña de una cuenta break-glass con el login con GitHub o con OIDC activo lleva en login.success break_glass: true y method: password, y la página lo lee como «{login} inició sesión con la contraseña break-glass». Llega además a los administradores por correo y en la campanita (Avisos).
Pistas útiles: varios login.failure seguidos desde una misma IP, y eventos oidc.link con via email que no esperabas. «Avisos», en la barra superior, cuenta los de los últimos siete días.
Operativa
«Operativa», en «Registro» junto a «Auditoría», resume cómo se usan tus clusters: quién trabaja en ellos, qué se sale de lo normal y qué no usa nadie. También la abre «Operativa de los clusters», en las «Tendencias» de Inicio, y cada cifra de allí lleva a su parte de la página.
El periodo va en la cabecera: «7 días», «30 días» o «90 días», y la dirección de la página lo guarda (?period=7). En Free la página lee las últimas 24 horas: su periodo es «24 h», con «Con Pro: 7, 30 y 90 días».
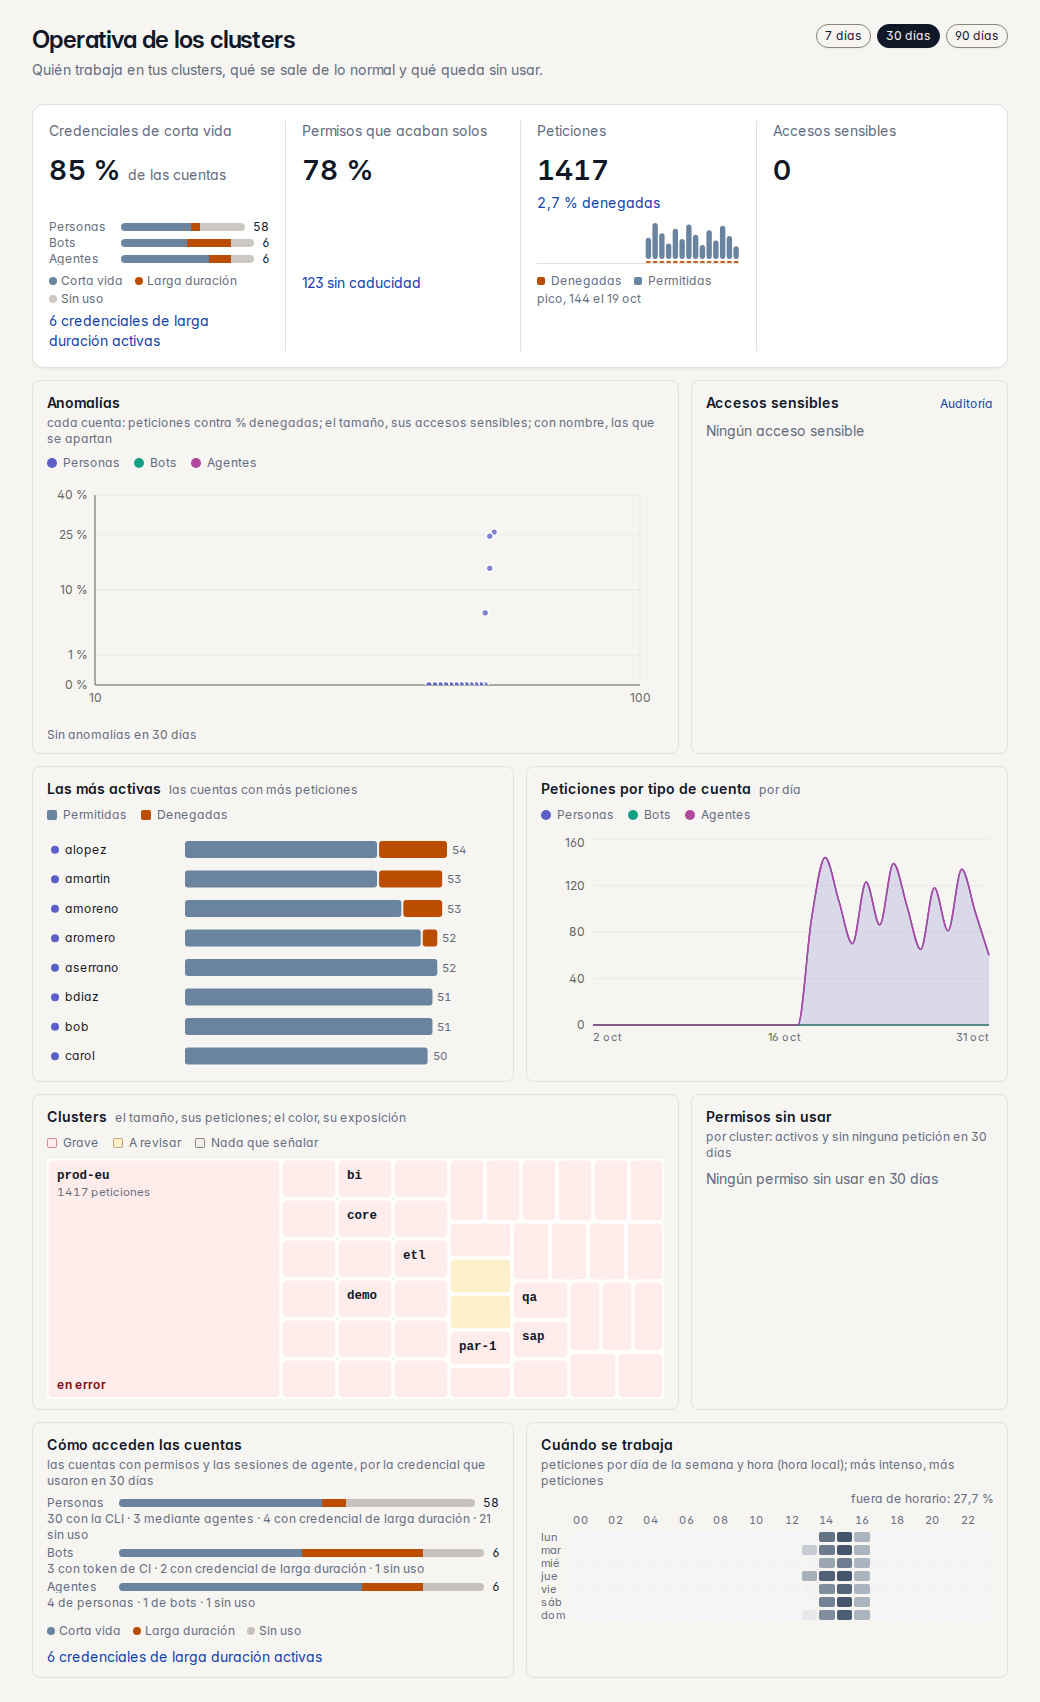
Arriba van cuatro cifras del periodo, cada una con su gráfica:
- «Credenciales de corta vida»: qué parte de las cuentas entró solo con credenciales que caducan solas (Corta vida y larga duración).
- «Permisos que acaban solos»: qué parte de los permisos activos tiene fecha de fin, cuánto ha cambiado en el periodo y su línea, con enlaces a los que no caducan («sin caducidad») y a las cuentas «con cluster-admin».
- «Peticiones»: el total y la parte denegada, que abre esas peticiones en «Auditoría». Hay una columna por día (por hora en Free) con las denegadas abajo, y «pico» dice cuál fue el día con más.
- «Accesos sensibles»: los
exec(yattach), las lecturas de Secrets y losport-forwarddel periodo, y cuántas cuentas los hicieron.
Debajo van ocho gráficas, y cada marca lleva a donde se ve el detalle o se arregla lo que enseña:
- «Anomalías»: una burbuja por cuenta, con sus peticiones en horizontal, su porcentaje de denegadas en vertical y sus accesos sensibles como tamaño, en el color de su tipo («Personas», «Bots», «Agentes»). Las cuentas que más se apartan llevan su nombre. Una burbuja abre la ficha de la cuenta; la de un agente de IA, la de la cuenta en cuyo nombre actúa.
- «Accesos sensibles»: los
exec, las lecturas de Secrets y losport-forwarddel periodo. Un sector abre «Auditoría» con esas peticiones. - «Las más activas»: las ocho cuentas con más peticiones, permitidas y denegadas. Una barra abre la ficha de la cuenta.
- «Peticiones por tipo de cuenta»: lo que piden cada día las personas, los bots y los agentes de IA.
- «Clusters»: cada cluster ocupa según sus peticiones y toma el color de su peor exposición: «Grave» si da privilegios a todos o está en error, y «A revisar» si tiene
cluster-adminsin caducidad, un Kubernetes fuera de soporte (más de tres versiones menores por detrás de aquella con la que se compiló kubelatch), el bootstrap v1 o permisos sin caducidad. Un rectángulo lleva a donde se arregla: «Necesita atención» o «Detalles» en la página del cluster, o «Permisos» con ese cluster. - «Permisos sin usar»: por cluster, los permisos activos sin ninguna petición en 30 días. Una barra los abre en «Lista» solo con ese cluster, y «Revisar los N», todos (Revocar varios permisos). Debajo, «y N credenciales sin usar» abre «Credenciales».
- «Cómo acceden las cuentas»: las personas, los bots y los agentes según la credencial que usaron, y en cada fila, cómo: «5 con la CLI · 1 sin uso», «2 con token de CI · 1 con credencial de larga duración», «2 de personas · 1 de bots». «N credenciales de larga duración activas» las abre en «Credenciales», y «N con permisos y sin actividad en 90 d» abre esas cuentas en «Usuarios».
- «Cuándo se trabaja»: las peticiones por día de la semana y hora, en la hora de tu navegador, y cuánto se pide «fuera de horario» (de lunes a viernes, de 08:00 a 20:00).
Una cuenta se aparta si tiene al menos 20 peticiones denegadas y su porcentaje de denegadas es como mínimo el triple de la mediana de las demás cuentas, y nunca menos del 5 %; o si tiene al menos 10 accesos sensibles y son como mínimo el triple de la mediana de las demás cuentas que tienen alguno. Las peticiones con un token desconocido, revocado o caducado salen como «Sin cuenta», y su burbuja abre las peticiones rechazadas en «Auditoría». La página cuenta también las peticiones que kubelatch rechaza antes de que lleguen a un cluster, así que, para los mismos días, puede contar más que «Peticiones, 7 días» en «Inicio».
El periodo lo mueve todo menos «Permisos sin usar», que siempre mira 30 días. En Free, «Peticiones» y «Peticiones por tipo de cuenta» van por horas, «Permisos sin usar» dice «Con Pro: los permisos que nadie usa en 30 días», y «Permisos que acaban solos» y las cifras de las cuentas, que no dependen de la auditoría, miran 30 días y lo dicen. Si la retención de tu auditoría guarda menos de 30 días, «Permisos sin usar» dice que no puede medirlos.
Corta vida y larga duración
«Credenciales de corta vida» y «Cómo acceden las cuentas» cuentan las cuentas activas con algún permiso en vigor, y los agentes de IA que trabajan para ellas, según la credencial que usaron en el periodo:
- «Corta vida»: una sesión de la CLI (12 horas por defecto, que
kubelatch loginrenueva), un token de CI (de una hora, que se canjea en cada ejecución) o la sesión delegada de un agente. Caducan solas. - «Larga duración»: una credencial estándar, que dura hasta 30 días en una persona y 90 en un bot, por defecto. Un agente que trabaja como bot entra con la credencial de su bot, así que también es de larga duración.
- «Sin uso»: no usó ninguna en el periodo.
Cada cuenta va a un solo grupo, y la larga duración manda: quien usa la CLI y además una credencial estándar sigue teniendo un secreto largo en uso. Una persona que solo ha trabajado mediante un agente cuenta como de corta vida, y el agente cuenta además en «Agentes». Hay un agente por cuenta y cliente (por ejemplo, el Claude Code de alice) con alguna sesión activa ahora o usada en el periodo. La cifra es la parte de corta vida entre las cuentas que entraron, sin contar «Sin uso»; si no entró nadie, dice «Nadie ha entrado en 30 días».
Las filas cuentan cómo entraron las cuentas durante el periodo, aunque la credencial ya esté revocada. «N credenciales de larga duración activas» cuenta las credenciales estándar que funcionan ahora, se usen o no: cada una es un secreto que sigue sirviendo hasta que caduque o la revoques.
Retención
KUBELATCH_AUDIT_RETENTION fija cuánto se guardan las peticiones y los eventos del plano de control. Por defecto, 90 días (90d). Acepta días (Nd) o una duración de Go, con un mínimo de un día. 0 o 0d desactiva el borrado, salvo que la instancia nunca haya tenido clave, lo que limita la retención a 24 horas.
En la edición Free y con una clave caducada, «Auditoría» muestra solo las últimas 24 horas: los listados informan del instante más antiguo servido en floor, y un evento más antiguo abierto por su Audit-ID responde 404, como un id desconocido. Una instancia que nunca tuvo clave conserva además la auditoría 24 horas como máximo (un valor mayor se recorta, y 0 también pasa a 24 horas); la que tiene o tuvo una clave mantiene su retención configurada y solo deja de servir lo anterior a 24 horas hasta instalar una clave. Ver Ediciones y licencia.
Una tarea periódica borra cada hora lo que supera la retención; la primera pasada, un minuto después de arrancar. El log dice cuántas filas borró (retention: rows deleted) o si falló (retention: pass failed).
Nadie más puede modificar ni borrar filas: ver Auditoría inmutable.
Datos personales
Las filas guardan la IP, el login, el User-Agent y la query string (el command= de cada exec). El plano de control guarda la IP y el login de cada intento de login. La finalidad es la seguridad y la trazabilidad del acceso a los clusters. El plazo de retención es la respuesta a «cuánto tiempo guardáis esto».
Si necesitas conservar más de lo que quieres tener en la base de datos, exporta a un almacenamiento inmutable antes de que la tarea de retención las borre: pg_dump -t audit_events -t control_events, o GET /api/audit y GET /api/control-events (API HTTP).
Tamaño
Cada petición es una fila de alrededor de 1 KB, y kubectl hace varias por comando sin contar el descubrimiento. Como referencia, 50 personas activas generan unos pocos cientos de MB en 90 días.
Para incluir la auditoría en las copias de seguridad, sigue en Actualizar y copias de seguridad.