Registrar un cluster
Registrar un cluster le da a kubelatch dos ServiceAccounts en él: una para hacer de proxy y otra para mantener el RBAC sincronizado. Al terminar, el cluster aparece como «Listo» en «Clusters» y ya puedes conceder permisos sobre él.
Antes de empezar
- Un administrador de kubelatch (Instalar).
- Un kubeconfig de administrador del cluster que vas a registrar, o un cluster que confíe en el cliente OIDC de kubelatch, para enrolarlo con tu identidad.
- Red: los pods de kubelatch deben llegar por https al API server. Si es privado, mira Clusters privados.
- Kubernetes 1.30 o superior en el cluster: el manifiesto bootstrap lleva una
ValidatingAdmissionPolicy, y la validación usaSelfSubjectReview.
flowchart LR
  A[«Registrar un cluster» en Clusters] --> B[Generar el comando de enrolamiento]
  B --> C[Ejecutarlo con el kubeconfig del cluster]
  C --> D[kubelatch valida y cifra]
  D --> E[Primera reconciliación]
Registrar el cluster
La edición Free admite 2 clusters; el tercer registro responde 422 edition.limit. En el tope, «Clusters» lo dice en una nota y «Registrar», en el panel, explica por qué no puede. Ver Ediciones y licencia.
-
En «Clusters», pulsa «Registrar un cluster». Se abre un panel a la derecha: rellena «Identificador (slug, va en la URL del proxy)» y «Nombre» y pulsa «Registrar». El identificador es un slug (minúsculas, dígitos y guiones, hasta 63 caracteres) y va en la URL del proxy:
https://<kubelatch>/clusters/<id>. Aterrizas en la página propia del cluster, con el estado «Sin enrolar», en su tarjeta «Enrolar». La tarjeta muestra los pasos mientras el cluster no está enrolado; para volver a ella, abre el cluster desde «Clusters» o elige «Enrolar» en el menú de su ficha o de su fila. -
Con el login con OIDC activo, la tarjeta pregunta primero «Cómo»: «Con mi identidad (Keycloak)», con el nombre de tu proveedor (Enrolar con tu identidad), o «Con el script», que es lo que siguen estos pasos. El script tiene tres pasos numerados. En el primero, «Dónde», escribe en «Contexto de kubectl (opcional)» el contexto de tu kubeconfig que apunta a ese cluster, o déjalo vacío para usar el actual. El comando lo lleva como
sh -s -- --context '<nombre>', y puedes cambiarlo aunque el comando ya esté generado. Si es el cluster donde se ejecuta el propio kubelatch, marca «kubelatch corre dentro de este cluster (usakubernetes.default.svc)». Pulsa «Generar comando».La mayoría de los clusters no necesitan nada más: kubelatch toma la dirección del API server del
serverde ese contexto. Si kubelatch llega al API server por otra dirección (una red privada, un DNS interno), abre «Opciones avanzadas» y escríbela en «URL del API server para kubelatch» (Clusters privados). Con la casilla marcada, ese campo se bloquea enhttps://kubernetes.default.svc, la dirección que usa un pod. -
En el segundo paso, «Comando», copia el «Comando de enrolamiento» y ejecútalo con el kubeconfig de administrador de ese cluster. Es un
curl … | shque usa el contexto del primer paso o, si lo dejaste vacío, el actual dekubectl. Con el kubeconfig en otro fichero, fíjalo en una subshell:(export KUBECONFIG=<kubeconfig-del-cluster>; <comando-de-enrolamiento>) -
El script imprime el contexto de kubectl y el API server que va a enrolar, y pregunta
Continue? [y/N]en tu terminal. Comprueba que son los de ese cluster antes de respondery: el manifiesto va al cluster al que apunte el contexto, y la nota «Comprueba el contexto antes de confirmar», bajo el comando, lo recuerda. Después aplica el manifiesto de bootstrap, espera hasta un minuto a que Kubernetes rellene los tokens y se los envía a kubelatch.
El tercer paso, «Esperando», sigue el comando mientras está pendiente («Esperando a que se ejecute el comando…»). Si un intento llega a kubelatch y falla, muestra el último con su motivo («Último intento fallido a las …»). Cuando kubelatch recibe los tokens, los valida y los guarda cifrados, la tarjeta dice «Enrolado. Primera reconciliación en marcha.», la cabecera cambia a «Listo» y la tarjeta se queda en la página, ahora con cómo va el cluster. Los tokens nunca se vuelven a mostrar.
El enlace es un secreto que sirve una vez y durante una hora: la tarjeta dice cuándo caduca («De un solo uso · caduca a las …»). No lo pegues en chats ni en tickets. El comando solo se ve en la pestaña que lo generó: si vuelves a la página, o la abre otro administrador, mientras el enlace está pendiente, la tarjeta dice «Enlace pendiente · válido hasta …», sin el comando, y ofrece «Generar otro comando». «Invalidar» cancela el enlace antes de usarse (el comando copiado deja de funcionar), y generar un comando nuevo sustituye al anterior. El enlace también deja de servir si el administrador que lo generó queda deshabilitado o pierde el rol de admin. Si el enlace caduca o se invalida, la tarjeta lo dice y ofrece «Generar un comando nuevo».
Generar o invalidar un comando y recibir los tokens dejan eventos en el plano de control (cluster.enrollment.create, cluster.enrollment.revoke y cluster.tokens con via: enrollment): ver Auditoría.
Enrolar con tu identidad
Con el login con OIDC activo, puedes enrolar un cluster entrando en tu proveedor de identidad en lugar de ejecutar un comando: kubelatch aplica él mismo el manifiesto de bootstrap con el ID token que te da el proveedor, guarda cifrados los tokens de las dos ServiceAccounts y descarta el tuyo. Sin terminal y sin kubeconfig. Funciona igual en las ediciones Free y Pro.
Cuándo funciona
El API server del cluster tiene que aceptar el ID token que kubelatch recibe en el login: confía en el mismo issuer, con el client ID de kubelatch (OIDC_CLIENT_ID) como audiencia, y saca de los claims del token tu usuario y tus grupos (el correo y, si eres administrador por un grupo, groups). Da igual que el cliente sea público o confidencial: lo que cuenta es la audiencia del token. Si tu proveedor solo incluye los grupos con un scope, añádelo a OIDC_SCOPES.
| Cluster | Cómo confía en el cliente de kubelatch |
|---|---|
| kubeadm, k3s, Talos, RKE2 | --oidc-issuer-url y --oidc-client-id con el client ID de kubelatch, o una AuthenticationConfiguration con esa audiencia |
| DOKS | Su inicio de sesión único, con el cliente público de kubelatch |
| EKS | Un proveedor de identidad OIDC asociado al cluster, con el client ID de kubelatch |
| EKS solo con IAM Identity Center | No acepta tokens OIDC: usa el script |
| AKS | La audiencia de sus tokens es la aplicación servidor de AKS: usa el script |
| GKE | Pide un token de acceso de Google: usa el script |
Un cluster sin SSO, o que confía en otro proveedor, sigue con el script: su API server rechaza el token. kubelatch no puede saber en qué confía un cluster antes de que entres, así que la opción lo avisa, con el nombre del cliente («Solo si el cluster ya confía en Keycloak con el cliente kubelatch de kubelatch; si no, usa el script.»), y el rechazo lo repite.
La identidad tiene que ser la tuya: la que tu cuenta tiene vinculada en el proveedor (Cómo se vinculan las cuentas), para que el registro de auditoría del cluster y el de kubelatch nombren a la misma persona. Sin ella, la opción aparece desactivada con «Tu cuenta no está vinculada a Keycloak. Vincúlala en Mi cuenta.» Una cuenta break-glass, que nunca está vinculada, lee «Tu cuenta es de emergencia y no tiene identidad de Keycloak: usa el script.»
Configurar el cluster
Sea cual sea el proveedor, el nombre que te da el API server necesita los permisos para aplicar el manifiesto, que tiene cluster-admin: un ClusterRoleBinding para tu usuario o para uno de tus grupos, tal como los nombra el cluster.
-
kubeadm, k3s, Talos, RKE2: arranca el API server con
--oidc-issuer-urlcon el issuer de tu proveedor (OIDC_ISSUER),--oidc-client-idcon elOIDC_CLIENT_IDde kubelatch y las opciones de claims de El SSO del cluster, proveedor a proveedor; en k3s, con--kube-apiserver-arg. O dale unaAuthenticationConfiguration(--authentication-config), que recarga sin reiniciarse y que admite varias audiencias, así que el cluster puede confiar en el cliente de kubelatch además de en el suyo (audienceMatchPolicy: MatchAny):apiVersion: apiserver.config.k8s.io/v1 # v1beta1 antes de Kubernetes 1.34 kind: AuthenticationConfiguration jwt: - issuer: url: https://auth.example.com/realms/acme # OIDC_ISSUER audiences: - kubelatch # OIDC_CLIENT_ID claimMappings: username: claim: email prefix: "oidc:" groups: claim: groups prefix: "oidc:" -
DOKS: pon el issuer de tu proveedor y el client ID de kubelatch en el inicio de sesión único del cluster. DOKS pide un cliente público (Cliente público o confidencial).
- EKS: asocia al cluster un proveedor de identidad OIDC con el issuer de tu proveedor, el
OIDC_CLIENT_IDde kubelatch como client ID y los claims de usuario y de grupos con sus prefijos (El SSO del cluster, proveedor a proveedor). - AKS y GKE: usa el script.
El cluster saca tu usuario de un claim del ID token: email en el ejemplo. Con un proveedor que no pone el correo en el ID token, como Entra ID sin su claim opcional email, el API server responde 401 aunque el issuer y la audiencia estén bien: mapea un claim que el token sí lleve, o añade el correo al token. Con email, el API server también rechaza un token cuyo email_verified sea false.
El cluster donde se ejecuta kubelatch
El formulario pregunta «¿Dónde está el cluster?». Para este, elige «kubelatch corre dentro de este cluster». kubelatch llega a él en https://kubernetes.default.svc y lo verifica con la CA que Kubernetes publica en cada namespace, en el ConfigMap kube-root-ca.crt, que el chart monta de solo lectura (Qué instala el chart). El formulario dice «kubelatch ya conoce la dirección y la CA de este cluster.» y no pide nada. Sin el montaje (un chart antiguo, clusterCA.mount: false, un kubelatch fuera de Kubernetes) dice «kubelatch no tiene la CA de este cluster: pégala.» y pide solo la CA. Si la CA montada no firma el certificado del API server (porque tiene un certificado de servidor propio), abre «Pegar la CA a mano» y pega la correcta: tras ese fallo, el panel lo abre solo. La salida del comando pegada ahí rellena solo la CA: kubelatch se queda con la dirección que tiene dentro del cluster.
Otro cluster
Elige «Otro cluster» y rellena «URL del API server» y «CA del API server»: desde la consola del proveedor, si las muestra (la de EKS enseña las dos en la ficha del cluster), o con el «Comando de solo lectura», que imprime solo esos dos datos y no habla con el cluster:
kubectl config view --minify --raw --flatten -o jsonpath='{.clusters[0].cluster.server}{"\n"}{.clusters[0].cluster.certificate-authority-data}'
Rellena «Contexto de kubectl (opcional)» y el comando lee ese contexto en lugar del actual. Pega sus dos líneas en «Salida del comando», junto a la nota de que kubelatch no necesita tu kubeconfig. Bajo «Lo que kubelatch va a usar», el panel enseña la URL y la CA, con cuántos certificados lleva la CA y la huella SHA-256 de cada uno: compárala con la que enseña tu proveedor o con openssl x509 -noout -fingerprint -sha256. Los campos se pliegan bajo «Escribir la URL y la CA a mano»; ábrelo para escribirlas o pegarlas tú: la URL pasa las mismas comprobaciones que la del script (Qué valida kubelatch), y la CA admite PEM o base64.
Dos avisos que nunca bloquean: una dirección que ya es la de otro cluster registrado («Esta dirección ya es la del cluster «prod»: comprueba que es el cluster que quieres enrolar.») y una dirección de loopback, que kubelatch abre desde su propio servidor, así que solo sirve si el API server corre en esa misma máquina.
Entrar en el proveedor
Bajo los campos, «Antes de salir» enumera qué va a pasar antes de que salgas: «Entras como» ana@acme.com en Keycloak; «Se aplica en» https://10.0.1.10:6443 · cluster «prod»; «Qué» crea el manifiesto, con «Ver el manifiesto», que enseña el propio manifiesto ahí mismo; y «Tu token»: «Solo sirve para esto y no se guarda.» Pulsa «Continuar en Keycloak»: kubelatch pide al proveedor que te proponga esa identidad, y es con la que tienes que entrar.
Mientras estás en el proveedor, el panel dice «Esperando a que vuelvas de Keycloak · caduca a las 10:42», con «Cancelar»: el acceso tiene 10 minutos. Al volver, kubelatch hace el trabajo en esa misma petición, normalmente en segundos y como mucho en dos minutos, y llegas a la página del cluster con «Enrolado con tu identidad. El API server te vio como oidc:ana@acme.com (grupos oidc:platform-admins). Reconciliación en marcha.» Mientras kubelatch aplica el manifiesto («kubelatch está aplicando el manifiesto…»), ni «Cancelar» ni un enrolamiento nuevo lo detienen, así que el cluster nunca se queda enrolado a medias. Otra persona administradora que abra el cluster entretanto ve el intento con tu login, nunca con tu correo («Esperando a que «ana» vuelva de Keycloak · caduca a las 10:42»), y su «Cancelar» pregunta antes («¿Cancelar el enrolamiento de «ana»?»): puede que estés entrando en ese momento.
«Reenrolar» y «Reenrolar sin cambiar los tokens» ofrecen los mismos dos caminos, y el panel dice cuál desde el principio: en su título («Reenrolar «prod» con tokens nuevos», «Reenrolar «prod» sin cambiar los tokens») y en la frase bajo el camino («Con tu identidad, kubelatch vuelve a aplicar el manifiesto y guarda tokens nuevos: los actuales dejan de funcionar.»). «¿Dónde está el cluster?» empieza en «Donde ya está», con la dirección registrada: kubelatch usa la dirección y la CA que ya tiene del cluster, y no hay nada que pegar. Si otra persona administradora cambia esa dirección mientras tienes la página abierta, kubelatch no sigue y el panel vuelve a leer el cluster, así que el token solo va adonde decía la página. Elige otro sitio solo para cambiarlas. Con tokens nuevos, «Antes de salir» añade «Los tokens actuales de kubelatch en el cluster se sustituyen.», y después la página dice «Reenrolado con tu identidad y con tokens nuevos.» Como con el script, volver a aplicar el manifiesto devuelve kubelatch-proxy a la regla de solo uids; kubelatch reconcilia el cluster en cuanto ha escrito en él, así que eso dura segundos.
Qué hace kubelatch con tu token
- Solo lo envía a esa URL, por TLS verificado únicamente con esa CA, y no sigue redirecciones. Un certificado que la CA no firma lo para todo antes de que el token salga.
- Pregunta al API server quién eres (
SelfSubjectReview) y qué versión tiene, y comprueba conSelfSubjectAccessReviewque puedes crear todo lo que lleva el manifiesto, antes de escribir nada. - Aplica el manifiesto de bootstrap, el mismo que aplica el script, objeto a objeto por server-side apply, y luego espera hasta un minuto a los dos Secrets de token y los lee.
- A partir de ahí solo usa los tokens de las ServiceAccounts: los valida como valida los del script y los guarda cifrados. Tu token nunca llega a la base de datos, a un evento, a una línea de log ni a una respuesta: vive solo en la petición que te trae de vuelta del proveedor.
El plano de control registra cluster.bootstrap, con tu identidad verificada y cómo te vio el API server, y cluster.tokens con via: identity (Auditoría).
kubelatch no pide tu kubeconfig
kubelatch no te pide tu kubeconfig, ni en esta pantalla ni en ninguna: lo que necesita, la URL del API server y su CA, no es secreto. Un kubeconfig de administrador (el de k3s y el de kubeadm llevan el certificado y la clave de cluster-admin) es la credencial más delicada que tienes a mano, y en una página web cualquier extensión del navegador con acceso a ella podría leerlo. La nota junto a los campos lo dice: «kubelatch no necesita tu kubeconfig.»
Si aun así pegas un kubeconfig o una credencial, el campo se borra en el acto y la página dice «Eso parece un kubeconfig entero. kubelatch no lo necesita ni lo lee: usa el comando, que solo imprime la URL y la CA.» No se envía nada, pero el texto ha estado un instante en la página: trata esa credencial como expuesta a las extensiones del navegador. Las defensas frente a las extensiones están en Modelo de seguridad.
Si falla
El panel dice «El enrolamiento con tu identidad no terminó» y cuándo, por qué, qué dejó el intento en el cluster y, si llegó hasta ahí, cómo te vio el API server, en monoespaciada. El primer botón es el que arregla la causa: «Usar el script» cuando el API server rechazó el token o a tu identidad le falta un permiso; «Corregir la CA» cuando la CA no firma el certificado del API server, que vuelve al formulario con la URL y la CA vacía, con el foco en ella; «Intentar de nuevo» en los demás casos, con la misma URL y la misma CA. «Qué significa este fallo» abre su fila en Solución de problemas. Si otra persona administradora abre el cluster, ve el intento con tu login («El enrolamiento con la identidad de «ana» no terminó»), sin tu correo, y su «Intentar de nuevo» empieza con el formulario vacío: tu URL y tu CA nunca reciben su token. Sin una identidad vinculada a tu cuenta, «Intentar de nuevo» espera y dice dónde vincularla.
kubelatch no escribe nada en el cluster cuando el API server rechaza el token, cuando la CA no firma su certificado (el token ni siquiera sale), cuando el cluster tiene un Kubernetes anterior a la 1.30, o cuando a la identidad que ve el API server le falta un permiso que el manifiesto necesita, que el mensaje nombra. Un objeto rechazado al aplicar sale con la respuesta del API server; lo ya aplicado se queda, como con el script, y volver a intentarlo es idempotente. Los tokens que no aparecen en un minuto, o que no validan, no se guardan, y el manifiesto se queda aplicado. Un reenrolamiento con tokens nuevos elimina los anteriores antes de aplicar, así que cuando falla después de las comprobaciones el panel añade «Como pedía tokens nuevos, puede que los anteriores ya estén eliminados: kubelatch no llega al cluster hasta que un enrolamiento termine.»: el proxy y el reconciliador se quedan fuera hasta que uno termine. Un acceso que no termina (cancelado en el proveedor, otra identidad) dice por qué igual que el login (Cuando un acceso falla). Cada mensaje y su solución: Solución de problemas.
Opciones del script
Pásalas después de sh -s --, por ejemplo curl … | sh -s -- --yes:
| Opción | Qué hace |
|---|---|
--context <nombre> |
Usa ese contexto de kubectl en lugar del actual. |
--server <url> |
La dirección del API server que usará kubelatch. Gana a la de la tarjeta; sin ninguna de las dos, el script toma el server del kubeconfig. |
--rotate |
Borra los dos Secrets de tokens antes de aplicar el manifiesto, para que Kubernetes emita otros nuevos. La tarjeta lo incluye con «Reenrolar», que pide tokens nuevos (Rotar los tokens de las ServiceAccounts). |
--yes |
Se salta la confirmación. Sin ella, el script pregunta en la terminal (/dev/tty) y, sin terminal (CI, una tubería sin tty), se detiene con no terminal to confirm on: rerun with --yes. |
El script necesita kubectl, curl y base64 en el PATH, y curl 7.76 o superior. Los tokens viajan a kubelatch en el cuerpo de un POST enviado por stdin: nunca aparecen en los argumentos de un proceso. Si kubelatch usa un certificado de una CA privada, indica a curl esa CA para los dos pasos, la descarga y el POST: CURL_CA_BUNDLE=/ruta/ca.crt, junto a KUBECONFIG en la subshell.
Si kubelatch rechaza los tokens (por ejemplo porque no llega al API server), el script lo dice, la tarjeta muestra el intento y su motivo, y el enlace sigue valiendo hasta que caduque, se use o se rechace 10 veces: vuelve a ejecutarlo, con --server si hace falta.
Hacerlo a mano
El mismo registro paso a paso, si no puedes ejecutar el comando (por ejemplo porque la shell del cluster no tiene curl). Bajo «Hacerlo a mano», al pie de la tarjeta:
-
Descarga el manifiesto («descargar bootstrap.yaml») y aplícalo con el kubeconfig de administrador de ese cluster:
kubectl --kubeconfig <kubeconfig-del-cluster> apply -f kubelatch-bootstrap-<id>.yamlCrea el namespace
kubelatch-system, las ServiceAccountskubelatch-proxyykubelatch-reconcilercon un Secret de token cada una, los ClusterRoleskubelatch-proxyykubelatch-reconcilery sus dos ClusterRoleBindings, y la política de admisiónkubelatch-reconciler-jailcon su binding, que acota lo que el reconciliador puede escribir (Modelo de seguridad). En un cluster anterior a la 1.30,kubectl applyfalla con el kind de esa política. -
Copia el «One-liner» y ejecútalo con el mismo kubeconfig. Usa el contexto actual de
kubectl, así que fíjalo en una subshell:(export KUBECONFIG=<kubeconfig-del-cluster>; <one-liner>)Espera hasta un minuto a que Kubernetes rellene los tokens e imprime un JSON con
server,ca,proxyTokenyreconcilerToken. Lee la CA con--flatten, así que también vale un kubeconfig concertificate-authority: <fichero>. -
Pega el JSON en «JSON de los tokens» y pulsa «Guardar tokens».
kubelatch valida los tokens contra el cluster, los guarda cifrados y lanza la primera reconciliación; la tarjeta dice «Tokens guardados. Reconciliación en marcha.»
Qué valida kubelatch
- La URL del API server: solo
https, sin usuario, query ni fragmento, y nunca una IP literal link-local, de metadatos o multicast (los nombres no se resuelven para comprobarlo). - La CA: el PEM en base64 (
certificate-authority-data) o el PEM tal cual. - La identidad de cada token con
SelfSubjectReview:proxyTokendebe serkubelatch-proxyyreconcilerToken,kubelatch-reconciler. - Los permisos de cada ServiceAccount con
SelfSubjectAccessReview: el proxy debe poder suplantaruids; el reconciliador, leer los objetos RBAC, escribir ClusterRoles y bindings,bindde los roles de cada nivel, listar namespaces y crearSubjectAccessReviews. Pasan tanto el manifiesto actual como el anterior: la reconciliación averigua cuál tiene el cluster (Actualizar el bootstrap).
Si algo falla, el 400 dice qué: proxyToken: el token pertenece a …, la ServiceAccount kubelatch-reconciler no tiene el permiso …: aplica el manifiesto bootstrap de nuevo. Más casos en Solución de problemas.
Comprueba que funciona
- En «Clusters», la ficha del cluster dice «Listo», y la columna «Última pasada» de la «Lista», hace cuánto se reconcilió (
reconciliado hace 3 min). Hasta que termina la primera pasada diceprimera reconciliación en marcha: recarga la página si tarda más de unos segundos. - En la página del cluster, «Detalles», en la pestaña «Estado», da la «Versión de Kubernetes», el «Proveedor» (
Amazon EKS,K3s,Kubernetes…; cómo se deduce) y el «Bootstrap» (v2), y «Namespaces», en la pestaña «Acceso», lista los namespaces con su nivel PSA (PSA restricted,sin PSA…). -
En el cluster aparecen los ClusterRoles de cada nivel:
kubectl --kubeconfig <kubeconfig-del-cluster> get clusterroles -l app.kubernetes.io/managed-by=kubelatch
La pantalla «Clusters»
«Clusters» abre con una frase de cifras: cuántos clusters hay y en cuántos proveedores, cuántos necesitan atención, cuántos tienen avisos y cuántos están sin enrolar (12 clusters en 3 proveedores · 1 necesita atención · 2 con avisos), o todos listos. Debajo vienen «Necesita atención», cuando algo la necesita, y dos pestañas con los mismos clusters: «Diagrama» y «Lista». En el móvil se abre la «Lista», y el «Diagrama» queda a una pestaña. La vista se guarda en la dirección (?view=list). Junto a las pestañas, «Entorno» y «Etiqueta» dejan en las dos vistas solo los clusters de un entorno o con una etiqueta (Entornos y etiquetas).
Necesita atención
Cada cluster tiene un nivel, el peor de lo que dice, y la tarjeta lista lo que necesita atención en este orden:
| Nivel | Píldora | Cuándo | Enlace |
|---|---|---|---|
| 1 · Seguridad | «Bloqueo» | Un nombre privilegiado incumple la regla de las 8 horas, o un rol que un namespace deja sin efecto deja a personas sin todo el cluster. La línea dice cuántas personas se quedan sin acceso y por qué. | «Cómo arreglarlo», a Necesita atención en la página del cluster. |
| 1 · Seguridad | «Expuesto» | El cluster da acceso privilegiado a cualquiera que se autentique. | «Cómo arreglarlo». |
| 2 · kubelatch no puede trabajar | «Sin conexión» o «Token rechazado» | kubelatch no llega al servidor de API del cluster, o el servidor rechaza el token del reconciler. La línea dice cuándo fue la última pasada que funcionó. | «Cómo arreglarlo». |
| 2 · kubelatch no puede trabajar | «Atrasado» | Ninguna pasada ha terminado en el cluster en 30 minutos, tres veces el periodo de la reconciliación. | «Cómo arreglarlo». |
| 2 · kubelatch no puede trabajar | «Error» | Cualquier otro problema de un cluster en error: la línea dice el primero. | «Cómo arreglarlo». |
| 3 · Avisos | «Aviso» | Bootstrap v1, una versión de Kubernetes fuera de soporte, cuentas que no se pueden nombrar o un rol sin efecto en un namespace que no deja a nadie fuera. Van todos en una línea. | «Ver», a la «Lista» con «con avisos» pulsado. |
Los niveles 1 y 2 llevan una línea por cluster, cinco como mucho; «y N más» abre la «Lista» con «necesitan atención» pulsado. Un cluster sin enrolar no es una incidencia y nunca sale aquí. Si no hay nada que contar, la tarjeta no se dibuja.
El diagrama
El diagrama dibuja kubelatch arriba, con cómo entra la gente (Entrada con Google y con GitHub), y debajo los clusters en cajas. «Agrupar por», junto a las pestañas, elige las cajas: por «Proveedor», por «Entorno» o por cada valor de una clave de etiqueta (Agrupar el diagrama). Abre por «Entorno» en cuanto algún cluster tiene uno, y por «Proveedor» si no. Por proveedor, las cajas son «AWS», «Google Cloud», «Azure», «DigitalOcean», «Scaleway», «OVHcloud», «Exoscale», «Aruba», «Red Hat», «Propios y edge» (K3s, RKE2, kind, Talos Linux, Kubernetes genérico y cualquier otro) y «Sin enrolar». Van siempre en ese orden, en tantas columnas como quepan en la pantalla, y una vacía no se dibuja. Cada caja lleva sus clusters, primero el peor, como fichas: la marca del proveedor y el identificador, y debajo la píldora de su nivel («Listo», «Aviso», «Error»…), el producto y la versión de Kubernetes (EKS · 1.32), con bootstrap v1 cuando lo es. La línea que lleva a una caja con un cluster de nivel 1 o 2 va en rojo.
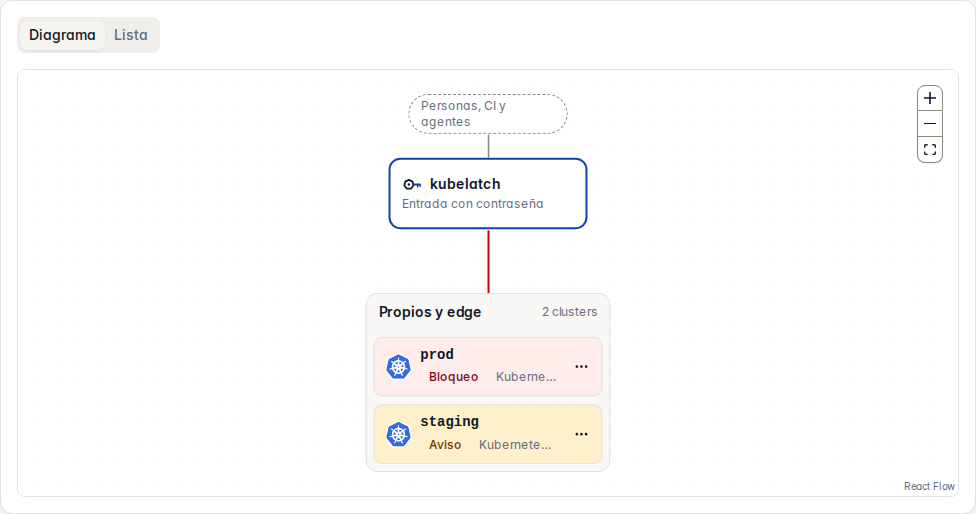
Pulsa una ficha para abrir la página del cluster; su menú tiene «Enrolar» (hasta que está enrolado) o «Reconciliar», y «Eliminar». Una caja con más de seis clusters deja una ficha a cada uno que tiene algo que contar y junta los demás en «N listos», un chip por cluster que abre su página. La rueda del ratón desplaza la página: haz zoom con los botones de arriba a la derecha y arrastra el lienzo para moverlo. Con el teclado, el tabulador recorre las fichas caja a caja, cada ficha y luego su menú.
La lista
La «Lista» dice lo mismo en una tabla, primero el peor: el cluster con su nombre debajo, la píldora de su nivel, el proveedor, la versión de Kubernetes (con fuera de soporte cuando lo está), el bootstrap, la última pasada (reconciliado hace 3 min, falló por última vez hace 2 h) y tres cifras que enlazan a las listas que cuentan: cuentas, permisos y credenciales restringidas a él. La búsqueda mira el identificador y el nombre, y los chips «necesitan atención», «con avisos» y «sin enrolar», cada uno con su número, estrechan la lista y se quedan en la dirección. En el móvil, cada cluster es una fila.
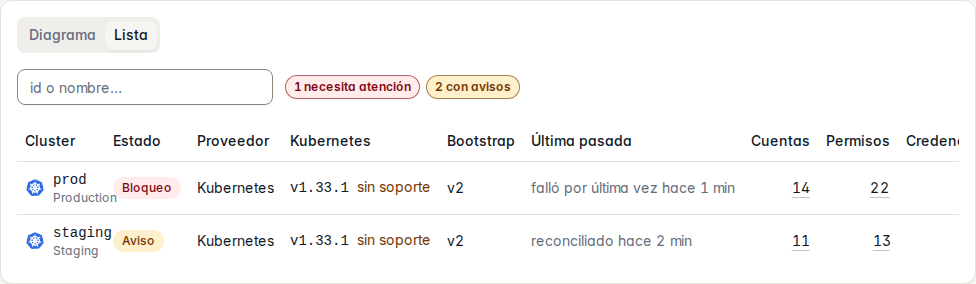
Las marcas de proveedor siguen el ajuste KUBELATCH_PROVIDER_LOGOS: published por defecto, all o none. El nombre del proveedor se muestra siempre en texto.
La página del cluster
Pulsa una ficha del diagrama, o un cluster de la «Lista», para abrir la página propia del cluster, /admin/clusters/<id>. La cabecera dice qué es el cluster y cómo va, con la misma palabra que su ficha en «Clusters»: la marca del proveedor y el identificador, el nombre, la píldora de su nivel («Listo», «Aviso», «Bloqueo»…), su entorno (prod · Producción si está marcado como producción, solo el id si no), el producto y la versión de Kubernetes (Amazon EKS · 1.33, con fuera de soporte cuando lo está) y la última pasada: reconciliado hace 3 min; última pasada buena a las 10:05 (hace 1 h) mientras el cluster está bloqueado o kubelatch no puede trabajar en él; última pasada hace 2 h cuando va «Atrasado». Debajo van las etiquetas del cluster y «Entorno y etiquetas», que cambia las dos cosas (El entorno y las etiquetas de un cluster). «Reconciliar» y, en el menú (el botón de los tres puntos), «Reenrolar» y «Reenrolar sin cambiar los tokens» aparecen cuando el cluster está enrolado; «Eliminar» está siempre.
Debajo de la cabecera hay tres pestañas. La página abre siempre en «Estado», y la pestaña se guarda en la dirección (?tab=access, ?tab=inside):
- «Estado»:
- «Necesita atención», cuando el cluster tiene algo que contar (más abajo).
- Cuatro cifras: «Sin acceso» (las personas a las que un problema deja sin el cluster), «Caducan hoy», «Sin caducidad» y «Credenciales activas en este cluster».
- «Actividad reciente», en dos partes. «Cambios» enseña los 10 últimos cambios del plano de control en este cluster, los suyos y los de sus permisos: quién concedió qué y cuándo. «Peticiones» enseña las 20 últimas peticiones, cada una con su detalle. «Abrir en Auditoría» lista el resto, filtrado por este cluster.
- «Detalles»: «API», «Versión de Kubernetes», «Proveedor», «Bootstrap», «Registrado», «Ruta del proxy» y «Contexto de kubeconfig».
- «Acceso»:
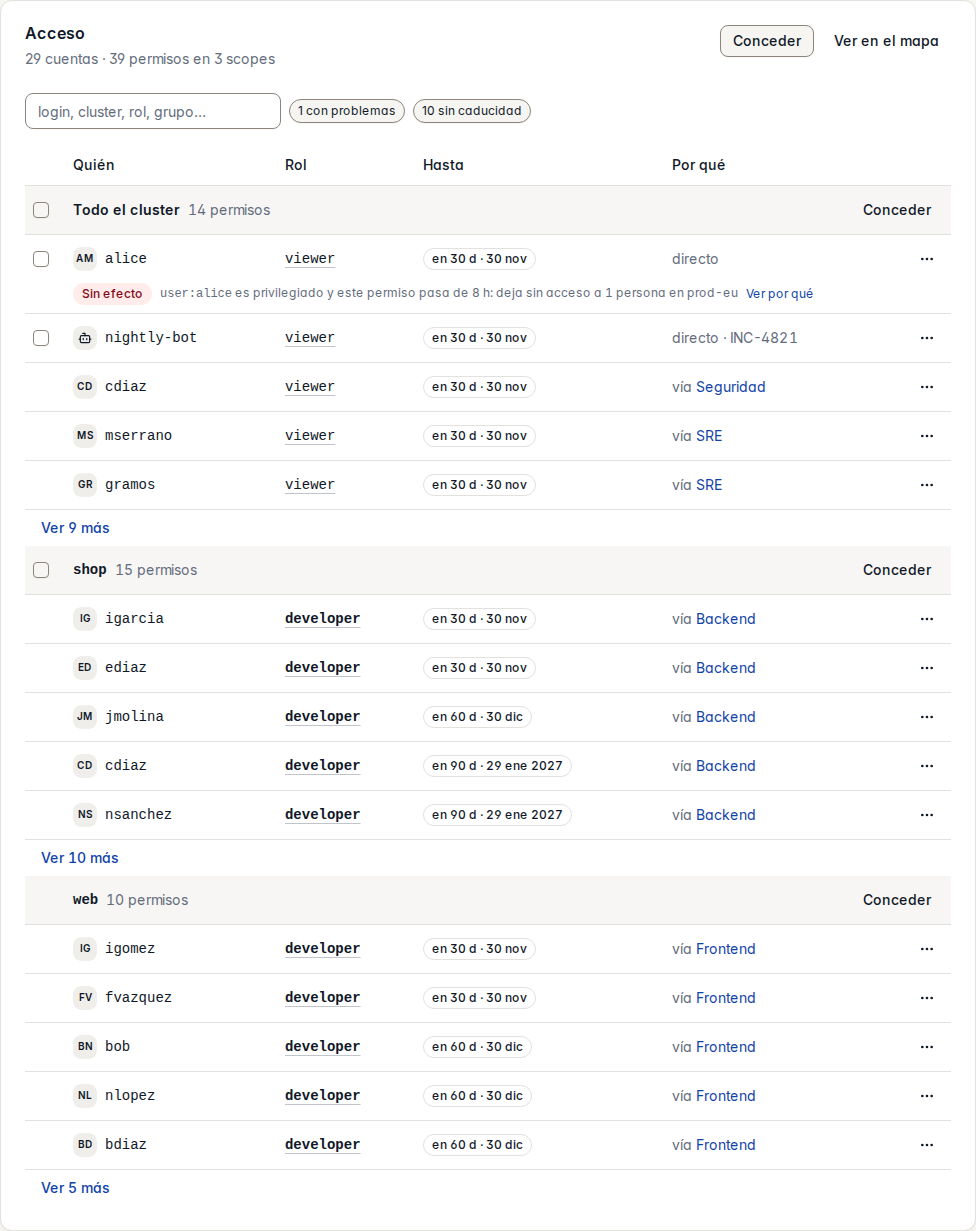
- «Acceso»: los permisos activos, agrupados por namespace (primero todo el cluster), una línea cada uno con la cuenta, el rol, la caducidad y si es directo o llega por un grupo (Leer un permiso). Una frase los cuenta (
29 cuentas · 39 permisos en 3 scopes). La búsqueda encuentra una cuenta por su login, su nombre, el rol, el namespace, la nota o sus grupos, y los chips de Permisos estrechan las líneas: «caducan hoy», «esta semana», «con problemas», «sin caducidad» y «cluster-admin»; «Limpiar» quita las dos cosas. Un namespace con más de 8 permisos enseña 5 y «Ver N más». Lo que impide que un permiso funcione sale bajo su línea, y los de una cuenta deshabilitada van atenuados. «Conceder» abre el formulario de permisos de Permisos con el cluster ya relleno y, junto a un namespace, también ese namespace; «Ver en Permisos» abre «Permisos» sobre este cluster. - «Namespaces»: un filtro por nombre y, de cada namespace, su nivel PSA, los permisos vigentes y «Conceder». Un namespace protegido dice «Protegido» en su lugar. Marca varios y elige «Conceder en N namespaces» en la barra para abrir el formulario con todos ellos.
- «Acceso»: los permisos activos, agrupados por namespace (primero todo el cluster), una línea cada uno con la cuenta, el rol, la caducidad y si es directo o llega por un grupo (Leer un permiso). Una frase los cuenta (
- «Dentro del cluster»:
Un cluster sin enrolar no tiene pestañas: bajo su cabecera van la tarjeta «Enrolar», los permisos concedidos hasta ahora, que llegan al cluster cuando se enrole, y «Detalles». Un reenrolamiento abre su tarjeta encima de las pestañas, y ahí se queda, abras la pestaña que abras, hasta que el comando se ejecuta o lo cancelas.
«Necesita atención» en la página del cluster
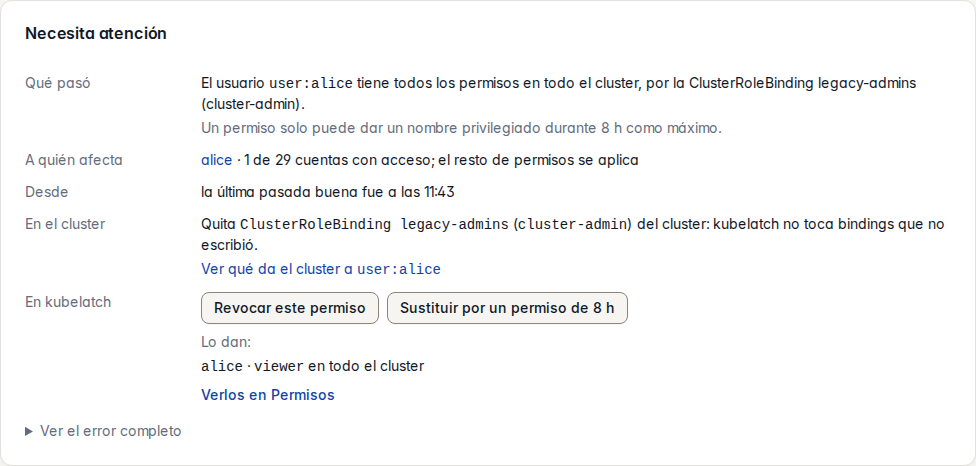
Cada señal del cluster es un bloque, primero la peor, en el orden de Necesita atención de «Clusters». Un bloque tiene hasta cinco filas:
- «Qué pasó»: el problema, en el idioma de la interfaz.
- «A quién afecta»: las personas, por su login, y cuántas son de las cuentas con acceso (
alice · 1 de 29 cuentas con acceso; el resto de permisos se aplica). - «Desde»: cuándo fue la última pasada buena, mientras el cluster está bloqueado o kubelatch no puede trabajar en él.
- «En el cluster»: lo que solo se arregla en el cluster, con la prueba.
- «En kubelatch»: lo que puede hacer kubelatch.
«En el cluster» va siempre antes que «En kubelatch». Bajo los bloques, «Ver el error completo» enseña el texto en inglés de un cluster en error. Qué dice cada problema, y cómo se arregla, está en La reconciliación.
Qué hacer con un nombre privilegiado
Cuando el cluster da acceso privilegiado al nombre con el que entra una persona, y un permiso suyo dura más de 8 horas, el cluster dice «Bloqueo» y esa persona no puede usarlo a través de kubelatch (Cuando el cluster da acceso privilegiado a un nombre). El bloque ofrece tres salidas, por este orden:
- Primero, en el cluster. Cuando el privilegio lo da un binding que no escribió kubelatch, el bloque lo nombra, como
Quita ClusterRoleBinding legacy-admins (cluster-admin) del cluster: kubelatch no toca bindings que no escribió., y «Ver qué da el cluster auser:alice» lo enseña en Lo que este cluster conoce. Quita ese binding con el kubeconfig de administrador del cluster: desde la siguiente pasada el nombre deja de ser privilegiado y los permisos de la persona se aplican tal como están. Cuando el privilegio sale de un namespace privilegiado, el bloque dice qué lo hace privilegiado, y eso es lo que hay que quitar. Un rol nativo que da acceso privilegiado lo da a propósito: se concede 8 horas como mucho. - Después, en kubelatch, «Revocar este permiso», o «Revocar estos N», revoca los permisos que duran demasiado, con la confirmación de Revocar varios permisos. Elígelo cuando esa persona no deba usar el cluster a través de kubelatch. Un permiso de grupo enlaza a su grupo, y una sesión de agente tiene «Cortar la sesión».
- O bien, si el nombre es de una persona, «Sustituir por un permiso de 8 h» revoca el permiso y concede el mismo rol, en el mismo sitio, durante 8 horas. Durante esas 8 horas la persona entra con todo lo que el cluster da a ese nombre, no solo con lo que permite el rol, y la confirmación lo dice antes que nada:
Durante esas 8 h, «alice» entra con lo que el cluster da a user:alice: tiene todos los permisos en todo el cluster, por la ClusterRoleBinding legacy-admins (cluster-admin).
Si la revocación sale bien y el permiso nuevo se rechaza, el bloque lo dice y «Volver a conceder» abre el formulario de permisos con la cuenta, el cluster, el namespace y el rol ya rellenos. El plano de control registra los dos cambios, la revocación con su motivo (Auditoría y retención). Un nombre privilegiado de grupo solo ofrece revocar: sustituir daría acceso privilegiado a todos sus miembros a la vez.
El proveedor del cluster
Cada cluster enseña la plataforma en la que se ejecuta: «Amazon EKS», «Google Kubernetes Engine», «Azure Kubernetes Service», «DigitalOcean Kubernetes», «Red Hat OpenShift», «K3s», «RKE2», «Scaleway Kapsule», «Exoscale SKS», «OVHcloud Managed Kubernetes», «Aruba Managed Kubernetes», «Talos Linux», «kind» o «Kubernetes», el genérico. Es una etiqueta para las personas: no cambia ningún permiso y funciona igual en las ediciones Free y Pro. El diagrama, la «Lista» y «Detalles» dibujan su marca, como fije KUBELATCH_PROVIDER_LOGOS, y su nombre en texto. La fila «Proveedor» de «Detalles» añade de dónde sale: «(detectado)», «(fijado a mano)» o, antes de la primera reconciliación, «(sin detectar todavía)».
Cada reconciliación lo deduce, así que los clusters registrados antes de esta versión lo tienen tras su siguiente pasada, sin volver a aplicar el bootstrap. Mira, por este orden:
- Los grupos de API que sirve el cluster:
config.openshift.iosignifica OpenShift. - La versión de Kubernetes que se leyó al enrolar el cluster:
-eks-significa Amazon EKS,-gke.Google Kubernetes Engine,+k3sK3s y+rke2RKE2. - La dirección del API server, cuando acaba en
.eks.amazonaws.com(Amazon EKS),.azmk8s.io(Azure Kubernetes Service),.k8s.ondigitalocean.com(DigitalOcean Kubernetes),.api.k8s.<región>.scw.cloud(Scaleway Kapsule, enfr-par,nl-amsypl-waw),.sks-<zona>.exo.io(Exoscale SKS, en sus siete zonas) o.k8s.ovh.net(OVHcloud Managed Kubernetes).
Sin ninguna señal, dice «Kubernetes». Nunca dice «kind», «Talos Linux» ni «Aruba Managed Kubernetes»: esos se fijan a mano. Un cluster registrado con «kubelatch corre dentro de este cluster» tiene la dirección https://kubernetes.default.svc, que no dice nada, así que en Azure Kubernetes Service y en DigitalOcean Kubernetes fija el proveedor a mano. Si el cluster no responde a la lectura de sus grupos de API, la pasada conserva el valor que tenía.
Para fijarlo a mano, pulsa «Editar» en la fila «Proveedor» de «Detalles». La lista empieza con «Automático (…)», el deducido, y sigue con los nueve proveedores; «Guardar» lo aplica al momento, sin confirmación, y «Automático» devuelve la decisión a kubelatch. Lo que fijes se queda hasta que lo quites, y la reconciliación sigue deduciendo el otro, así que «Automático (…)» siempre está al día. Cada cambio queda registrado como cluster.provider.update (Auditoría y retención); PATCH /api/clusters/<id> hace lo mismo.
Identidad en el cluster
La tarjeta «Identidad en el cluster» fija el nombre que lleva cada persona dentro del cluster cuando kubelatch lo llama: el Impersonate-User que manda el proxy. El valor por defecto, user:{login}, es el nombre propio de kubelatch (user:ana). Un cluster cuyo SSO ya nombra a las personas de otra forma puede usar ese nombre, para que el audit log del apiserver y los bindings a usuarios nombren igual a cada persona entre por donde entre. Por qué, y qué cambia, lo cuenta kubelatch encima del SSO que ya tienes; qué plantilla va con cada proveedor, El SSO del cluster, proveedor a proveedor.
La plantilla es texto libre alrededor de exactamente una variable:
| Variable | Qué es |
|---|---|
{login} |
El login de kubelatch de la cuenta. |
{email} |
El correo verificado de la identidad de la cuenta en el proveedor OIDC de kubelatch. |
{oidc_subject} |
El sujeto de esa identidad: el valor del claim que nombra OIDC_SUBJECT_CLAIM. |
{github_login} |
El login de GitHub vinculado a la cuenta. |
oidc:{email} nombra a Ana oidc:ana@acme.com. El texto fijo no puede empezar por system: ni llevar espacios, caracteres de control ni llaves sueltas, y un nombre rendido ocupa 253 caracteres como máximo. user: y bot: son los nombres propios de kubelatch, para las personas con la plantilla por defecto, los agentes de IA y los bots: solo la plantilla por defecto empieza por user:, y ninguna empieza por bot: (400 cluster.template_reserved_prefix). {email} y {oidc_subject} necesitan el login con OIDC configurado: sin él nadie los tiene, y guardar responde 409 cluster.template_needs_oidc. El correo que teclea un administrador en «Usuarios» nunca cuenta: solo el que garantizó el proveedor. Los bots entran siempre como bot:<nombre>.
Con el acceso por dominio o las solicitudes de alta, los logins se reparten por orden de llegada entre todos los dominios permitidos: bob@contractor.io puede quedarse con el login bob que los bindings del cluster pensaban para bob@acme.com. En un cluster que enlaza usuarios por nombre, elige entonces {email} o {oidc_subject}.
Para cambiarla, pulsa «Editar», escribe la plantilla en «Cómo entra cada persona (Impersonate-User)» y pulsa «Guardar». La vista previa de debajo sigue lo que escribes. Si la plantilla nueva deja gente fuera o hace que dos cuentas compartan nombre, «Guardar una plantilla que deja gente fuera» dice cuántas y pregunta antes; «Guardar de todos modos» la guarda, porque a veces el paso intermedio es inevitable.
Al guardar, kubelatch registra un cluster.identity.update con la plantilla anterior y la nueva (Auditoría y retención) y reconcilia el cluster al momento. Desde ese momento el proxy manda los nombres nuevos, y los streams abiertos con un nombre anterior (exec, port-forward, watch) se cortan en segundos; hasta que termina la reconciliación, una petición puede recibir el 403 del apiserver. Un cambio del correo de la persona en el proveedor, o de su login de GitHub, cambia su nombre en el cluster de la misma forma.
La vista previa
«Vista previa con quien tiene permisos aquí» rinde la plantilla, o el borrador mientras la editas, para cada persona con un permiso activo en el cluster:
- El nombre con el que entrará cada persona.
- Para quien no tiene lo que pide la plantilla, una píldora, «sin correo verificado», «sin identidad SSO» o «sin cuenta de GitHub vinculada», con lo que significa: «403 hasta que vincule su SSO». «nombre no válido» señala una cuenta cuyos datos no dan un nombre válido, como un correo que empezaría por
system:. - En «Dos cuentas entrarían con el mismo nombre», en rojo, las cuentas que compartirían nombre.
- La píldora «privilegiado» junto a un nombre al que el cluster da acceso privilegiado. Si el cluster no se puede leer, la vista previa lo dice y no muestra esa píldora.
Cuentas que no se pueden nombrar
Una persona cuya cuenta no tiene el dato que pide la plantilla no puede usar ese cluster a través de kubelatch. Sus peticiones reciben un 403 que dice por qué, como this cluster identifies people by their verified e-mail and the account `carol` has none: sign in with the identity provider, or ask an administrator to link it. Es un aviso, no un error: el cluster sigue «Listo», el resto sigue trabajando y cada reconciliación anota en el cluster las cuentas que no pudo nombrar. La página del cluster dice «Aviso» en su cabecera y las lista en «Necesita atención», con «Ir a Identidad en el cluster»; la tarjeta «Identidad en el cluster» abre con una nota que las lista, y su vista previa las enseña primero, con el porqué de cada una; en «Clusters», el cluster dice «Aviso» y «Necesita atención» lo nombra con los avisos.
Para {email} y {oidc_subject}, la persona entra una vez con el proveedor OIDC, que vincula su identidad (Cómo se vinculan las cuentas), o le mandas un enlace de vinculación desde «Usuarios». Para {github_login}, vincula GitHub (Login con GitHub). Sus otros clusters no se ven afectados.
Nombres que coinciden
Dos cuentas habilitadas que rinden el mismo nombre, como ana y ana.acme.com con el mismo correo verificado, no pueden entrar las dos: la reconciliación deja ese nombre fuera de lo que el proxy puede suplantar, las dos reciben el 403 del apiserver y el cluster pasa a «Error» con identity: logins ana and ana.acme.com both render `oidc:ana@acme.com`. Un permiso nuevo que provocaría una coincidencia así se rechaza con 409 grant.identity_collision. Cambia la plantilla o deshabilita una de las cuentas. El apiserver distingue a las personas de todos modos: Impersonate-Uid lleva siempre el identificador propio de la cuenta.
Cuando el cluster da acceso privilegiado a un nombre
Con una plantilla, el nombre que manda kubelatch puede ser uno al que el cluster ya da acceso: una persona a la que el cluster conoce como oidc:ana@acme.com, con una ClusterRoleBinding a edit, crea cargas de trabajo en todos los namespaces a través de kubelatch con cualquier permiso allí, aunque sea viewer. Por eso, cuando el cluster da a ese nombre acceso privilegiado, todo permiso de esa persona en ese cluster necesita una caducidad de 8 horas como máximo, sea cual sea su rol. Con cualquier plantilla distinta de la de por defecto, conceder lee en vivo el RBAC del cluster, y rechaza el permiso si el cluster no se puede leer. Cada reconciliación lo vuelve a leer, deja fuera un nombre con un permiso que incumple la regla y lo dice: privileged: the user `oidc:ana@acme.com` gets workloads in every namespace through ClusterRoleBinding ops-edit (edit) and the grant of ana has no 8 h expiry. La página del cluster nombra los permisos que lo causan y qué hacer, primero en el cluster (Qué hacer con un nombre privilegiado), y Permisos los marca. Un agente de IA en el que la persona delega nunca lleva ese nombre: entra como user:<login> (Agentes de IA).
Lo que este cluster conoce
La tarjeta «Lo que este cluster conoce» lista los sujetos de las RoleBindings y ClusterRoleBindings del cluster en dos tablas, «Grupos» y «Usuarios», y en la columna «Enlazado a», los roles de cada uno, en todo el cluster o en qué namespaces. Un nombre al que el cluster da acceso privilegiado lleva la píldora «privilegiado», con una línea debajo por cada razón: qué puede hacer, dónde y por qué binding y rol. Un nombre que empieza por system: dice «prohibido para roles nativos». Los nombres propios de kubelatch se pliegan en una línea («y 3 nombres de kubelatch»), y las ServiceAccounts no se listan.
Bajo las tablas, «Namespaces privilegiados» lista los namespaces privilegiados: los protegidos, y cada uno de los demás con la ServiceAccount que lo hace privilegiado. Cuando el cluster da acceso privilegiado a todo el que se autentica, o a todos los pods, la tarjeta abre con una nota que lo dice: kubelatch no puede limitarlo.
Sirve para elegir la plantilla de arriba y los grupos de un rol nativo sin teclearlos. kubelatch guarda la lectura cinco minutos («Leído hace 2 min.»); «Volver a leer» lee el cluster al momento. Cada lista se corta en 500 nombres. Leer no necesita ningún permiso nuevo: la ServiceAccount del reconciliador ya podía leer el RBAC del cluster.
La reconciliación
El reconciliador mantiene en el cluster los ClusterRoles de cada nivel, los de los roles personalizados en uso, un binding por cada rol y ámbito con permisos activos, y la lista exacta de usuarios y grupos que el proxy puede suplantar. kubelatch-proxy empieza permitiendo suplantar solo uids; el reconciliador le añade usuarios y grupos cuando hay permisos: los nombres que rinde la plantilla de identidad del cluster, y los grupos de los roles nativos con permisos activos, para los que no escribe ningún binding. Cada pasada lee además los ClusterRoles, las ClusterRoleBindings, los Roles y las RoleBindings del cluster, los suyos y los que no escribió, para aplicar la regla de las 8 horas del acceso privilegiado, y lista sus namespaces, para volver a comprobar el namespace de cada permiso: tiene que seguir existiendo y, para los roles que lo exigen, seguir aplicando Pod Security (las reglas). Pasa por cada cluster:
- Al cambiar algo: conceder o revocar un permiso, guardar tokens, deshabilitar o rehabilitar una cuenta, cambiar la plantilla de identidad, o un cambio en la identidad de alguien en el proveedor OIDC o en GitHub. Suele tardar menos de un segundo.
- Cuando un namespace con permisos cambia su etiqueta
pod-security.kubernetes.io/enforce, se borra o vuelve a crearse: en unos segundos, justo después de la pasada que esté en curso. kubelatch vigila los namespaces de cada cluster para enterarse; si no consigue vigilarlos (el log dicenamespace watch down), lo cubre la pasada de cada 10 minutos. Mientras los namespaces con permisos de un cluster no dejen de cambiar (una etiqueta que va y viene, namespaces que se crean y se borran), kubelatch reconcilia ese cluster al menos cada 30 segundos en lugar de a cada cambio, así que un cambio puede esperar hasta 30 segundos. - Cada 10 minutos. Esta pasada retira los bindings de permisos que han caducado (el proxy deja de aceptarlos en el instante en que caducan).
- A petición: «Reconciliar» en la página del cluster o en el menú de su ficha o su fila en «Clusters», o
POST /api/clusters/<id>/reconcile.
La llamada manual responde 200 con el cluster, 502 con el número de problemas si el cluster falla y 409 si ya hay otra pasada en curso o el cluster sigue «Sin enrolar».
Si una pasada falla, el cluster pasa a «Error», o al nivel que pida su problema («Bloqueo», «Sin conexión»…), y Necesita atención, en la pestaña «Estado» de su página, dice cada problema en el idioma de la interfaz, con su arreglo, y «Ver el error completo» da el texto en inglés. En «Clusters», «Necesita atención» dice su primer problema y enlaza a ellos.
- Un nombre privilegiado durante más de 8 horas, o dado por un permiso de grupo (la regla de las 8 horas): el bloque dice cómo da el cluster acceso privilegiado al nombre, enumera lo que lo da durante más tiempo (permisos, permisos de grupo, sesiones de agente) y a quién deja sin acceso. Se arregla primero en el cluster y después en kubelatch: Qué hacer con un nombre privilegiado. «Verlos en Permisos» enseña allí los permisos.
- Un namespace que ya no aplica Pod Security: un
developer,debugger,admino un rol personalizado que lo exige, en un namespace cuya etiquetapod-security.kubernetes.io/enforceya no esbaselinenirestricted, deja de surtir efecto en la siguiente pasada, y quien lo tiene conserva el resto de su acceso. El bloque da el comando para volver a poner la etiqueta, con un botón para copiarlo, y enumera los permisos sin efecto, con «Revocar estos N» y el enlace a su grupo. Cuando la etiqueta vuelve, vuelven a surtir efecto en la siguiente pasada, sin hacer nada en kubelatch. Si el namespace necesitaprivileged, por ejemplo para un agente de nodo, revoca los permisos en lugar de cambiar la etiqueta. Los roles nativos no se comprueban: lo que pueden hacer sus grupos lo decide el RBAC del propio cluster. - Un namespace que ya no existe: sus permisos dejan de surtir efecto. Revócalos, o vuelven a surtir efecto si el namespace vuelve.
- En los dos casos, cuando un binding que no escribió kubelatch también da el grupo de kubelatch de ese rol y namespace, o kubelatch no pudo eliminar su propio binding, quien tiene ese permiso pierde el acceso a todo el cluster hasta que se resuelva, y el bloque dice a cuántas personas afecta.
- Dos cuentas con un mismo nombre (Nombres que coinciden): cambia la plantilla de identidad o deshabilita una de ellas.
- Un bootstrap incompleto o anterior: «Reenrolar sin cambiar los tokens» abre los pasos para aplicar el manifiesto actual con los mismos tokens (Actualizar el bootstrap).
- Un rol personalizado que ya no pasa la validación: edita o elimina el rol al que enlaza.
- Una plantilla de identidad no válida: «Ir a Identidad en el cluster» y vuelve a fijarla.
- Un objeto que el cluster rechazó: el bloque lo nombra y dice qué respondió el cluster.
- El token del reconciler no se puede descifrar, o el cluster lo rechaza («Token rechazado»): «Reenrolar», en el bloque o en el menú de la página, con tokens nuevos.
kubelatch reintenta con espera creciente: 1, 2, 4… minutos, hasta 10. Un namespace que pierde Pod Security o se borra con permisos vigentes deja el cluster en «Error» hasta que se arregla o se revocan, pero el resto de bindings se siguen aplicando. Lo mismo pasa con los nombres que comparten dos cuentas, los nombres que deja fuera la regla de cluster-admin (Identidad en el cluster) y los roles nativos concedidos en un cluster con el bootstrap anterior (native roles are granted on this cluster but it has the previous bootstrap: apply the bootstrap manifest again). Una pasada que no puede leer el cluster conserva los permisos sin efecto que había encontrado hasta la siguiente que sí puede. El detalle del mecanismo está en Arquitectura.
Todo lo que kubelatch crea lleva las etiquetas app.kubernetes.io/managed-by=kubelatch y kubelatch.io/instance=<KUBELATCH_INSTANCE_ID>. Solo borra bindings con esas etiquetas y sus propios nombres, y nunca borra nada tras un error de lectura. Para añadir CRDs a un nivel, mira Conceder permisos.
Actualizar el bootstrap
El manifiesto bootstrap que genera kubelatch acota al reconciliador con la política de admisión kubelatch-reconciler-jail, en lugar de con la lista fija de nombres que le daba el manifiesto anterior (Modelo de seguridad). Un cluster registrado con el manifiesto anterior sigue funcionando con los niveles del sistema; los roles personalizados necesitan el nuevo.
Un cluster así dice «Bootstrap v1: en este cluster no se pueden conceder roles personalizados.» en «Necesita atención», en la pestaña «Estado» de su página. Para actualizarlo:
- Pulsa «Reenrolar sin cambiar los tokens», junto a esa línea (el menú de la página también lo tiene). La tarjeta abre los pasos, funciona como la del registro y dice que el comando aplica el manifiesto actual y envía los mismos tokens: rellena «Contexto de kubectl (opcional)» si quieres y pulsa «Generar comando».
- Ejecuta el comando con el kubeconfig de administrador de ese cluster. Aplica el manifiesto actual y envía a kubelatch los mismos tokens, así que nada de lo que los usa deja de funcionar, y la reconciliación empieza al momento. La tarjeta dice «Reenrolado sin cambiar los tokens. Reconciliación en marcha.»
A mano, en «Hacerlo a mano» de la misma tarjeta: descarga el manifiesto («descargar bootstrap.yaml») y aplícalo con el kubeconfig de administrador de ese cluster:
kubectl --kubeconfig <kubeconfig-del-cluster> apply -f kubelatch-bootstrap-<id>.yaml
Los tokens no cambian y no hay nada que pegar. kubelatch lo detecta en la siguiente reconciliación, como mucho 10 minutos después. Pulsa «Reconciliar» en la página justo después de aplicarlo: el manifiesto devuelve kubelatch-proxy a la regla de solo uids, como al rotar tokens, y el proxy no puede suplantar a nadie en ese cluster hasta que una reconciliación devuelva la lista.
En un cluster que ya tiene el manifiesto actual, cuando las notas de una versión digan que el manifiesto cambió, elige «Reenrolar sin cambiar los tokens» en el menú de la página: genera el comando, o descarga el manifiesto en «Hacerlo a mano», aplícalo y pulsa «Reconciliar» como arriba.
La política va primero en el manifiesto, así que kubectl la crea antes de ampliar el ClusterRole del reconciliador y los permisos nuevos no se conceden antes de que exista. El API server empieza a aplicar una política nueva unos segundos después de crearla. Si alguien borra después la política o su binding, o los debilita (un binding que solo avisa, por ejemplo), el cluster pasa a «Error» con bootstrap incomplete y kubelatch no escribe ahí ningún rol personalizado hasta que se vuelva a aplicar el manifiesto. Si se editó el binding, borra antes el ValidatingAdmissionPolicyBinding kubelatch-reconciler-jail: el manifiesto se aplica en el cliente y no quita un matchResources ni un paramRef añadidos por fuera. Tampoco borra los roles personalizados que ya estén en el cluster.
Si aplicaste la política de endurecimiento, la actualización pasa: el manifiesto no cambia los ClusterRoleBindings kubelatch-proxy y kubelatch-reconciler.
Rotar los tokens de las ServiceAccounts
Los tokens viven en los Secrets kubelatch-proxy-token y kubelatch-reconciler-token del cluster. Para cambiarlos, abre la página del cluster en «Clusters», abre su menú y elige «Reenrolar». La tarjeta, con el título «Reenrolar «--rotate incluido. Ejecútalo con el kubeconfig de administrador del cluster, como al registrarlo. El comando:
- Borra los dos Secrets: los tokens viejos dejan de funcionar y el proxy falla en ese cluster hasta que termina el comando.
- Vuelve a aplicar el manifiesto, así que Kubernetes crea tokens nuevos.
- Envía los tokens nuevos a kubelatch, que los guarda y lanza una reconciliación.
Volver a aplicar el manifiesto devuelve kubelatch-proxy a la regla de solo uids: el proxy no puede suplantar a nadie hasta la siguiente reconciliación. Guardar los tokens ya lanza una reconciliación que devuelve la lista (la tarjeta dice «Reenrolado con tokens nuevos. Reconciliación en marcha.»); «Reconciliar» solo sirve para confirmar que el cluster vuelve a «Listo».
La tarjeta describe el comando que muestra. Si pides al menú el otro reenrolamiento mientras hay un comando fuera, una línea dice qué hace el comando que ves («El comando que ves mantiene los tokens…» o «El comando que ves cambia los tokens…»); para tener el otro, «Invalidar» ese y genera otro. Cuando un enlace generado en otro sitio (otra pestaña, otro administrador) se ejecuta en un cluster enrolado, la tarjeta solo dice «Reenrolado. Reconciliación en marcha.»: no puede saber si ese comando cambió los tokens. «Cancelar» cierra los pasos si no hay ningún comando fuera.
También puedes rotarlos a mano: borra los dos Secrets con kubectl --kubeconfig <kubeconfig-del-cluster> -n kubelatch-system delete secret kubelatch-proxy-token kubelatch-reconciler-token, aplica el manifiesto y pega el JSON desde «Hacerlo a mano» en la misma tarjeta.
Endurecer el cluster (opcional)
Un admin de namespace, concedido por kubelatch o nativo, puede crear un RoleBinding a kubelatch-developer para quien quiera. Eso no da acceso a través de kubelatch, pero un sujeto con una credencial nativa obtendría ese rol de forma nativa, y además el binding confunde al reconciliador.
La política es files/vap-kubelatch-bindings.yaml del chart de Helm: una ValidatingAdmissionPolicy (Kubernetes 1.30 o superior). Solo deja a kubelatch-system/kubelatch-reconciler crear o cambiar bindings a un ClusterRole cuyo nombre empiece por kubelatch-. Los Roles de namespace quedan libres, se llamen como se llamen: kubelatch nunca enlaza uno, y la base de datos CloudNativePG del chart tiene el suyo. Aplícala en cada cluster gestionado, con su kubeconfig, desde el chart de la versión que usas (KUBELATCH_VERSION, como en Instalar):
helm pull oci://ghcr.io/picaportelabs/charts/kubelatch --version "$KUBELATCH_VERSION" --untar
kubectl --kubeconfig <kubeconfig-del-cluster> apply -f kubelatch/files/vap-kubelatch-bindings.yaml
Si el cluster de gestión también está registrado en kubelatch, el chart instala allí la política con hardening.enabled: true en tus values y un helm upgrade.
Aplícala después del bootstrap. Desde entonces, un binding creado a mano hacia un ClusterRole kubelatch-* se deniega, y el reconciliador sigue funcionando. Un cluster con la política de la 0.59.0 o anterior necesita la actual.
La política también frena al propio bootstrap. Sus ClusterRoleBindings kubelatch-proxy y kubelatch-reconciler apuntan a ClusterRoles kubelatch-*, y quien aplica el bootstrap es un administrador, no el reconciliador. «Reenrolar» funciona porque esos bindings no cambian. Pero un bootstrap que tenga que crearlos o cambiarlos falla con Forbidden:
- mover el cluster a otra instancia (cambia su etiqueta
kubelatch.io/instance); - registrarlo de nuevo después de quitar el bootstrap.
En esos casos, quita antes el binding de la política, aplica el bootstrap y vuelve a aplicar la política:
kubectl --kubeconfig <kubeconfig-del-cluster> delete validatingadmissionpolicybinding kubelatch-bindings
kubectl --kubeconfig <kubeconfig-del-cluster> apply -f kubelatch-bootstrap-<id>.yaml
kubectl --kubeconfig <kubeconfig-del-cluster> apply -f kubelatch/files/vap-kubelatch-bindings.yaml
En el cluster de gestión con hardening.enabled, el último paso es un helm upgrade con los mismos values, que vuelve a crear el binding.
Eliminar un cluster
En «Clusters», abre el menú de la ficha o la fila del cluster, o el de su página, elige «Eliminar» y confirma (o DELETE /api/clusters/<id>). kubelatch:
- Intenta limpiar el RBAC del cluster con el token del reconciliador, durante 15 s como mucho. Borra los bindings, los ClusterRoles de nivel y los ClusterRoles de los roles personalizados (
kubelatch-role-<id>) de esta instancia, y dejakubelatch-proxycon la regla de solouids. - Borra el cluster, sus permisos y las credenciales restringidas a él. Las filas de auditoría se conservan.
Cuando la limpieza fue bien, «Clusters» lo dice en un aviso (Cluster «<id>» eliminado; su RBAC se ha retirado del cluster.). Si no, un diálogo final, «Cluster
Si la limpieza no se hizo, retira lo que quede con el kubeconfig del cluster. Esto no toca el bootstrap:
kubectl --kubeconfig <kubeconfig-del-cluster> delete clusterroles,clusterrolebindings -l 'app.kubernetes.io/managed-by=kubelatch,kubelatch.io/kind in (binding,tier,role)'
kubectl --kubeconfig <kubeconfig-del-cluster> delete rolebindings -A -l 'app.kubernetes.io/managed-by=kubelatch,kubelatch.io/kind in (binding,tier,role)'
Con varias instancias de kubelatch, añade ,kubelatch.io/instance=<id> al selector.
Quita también el bootstrap
Eliminar el cluster no elimina el namespace kubelatch-system, las ServiceAccounts ni el ClusterRole del reconciliador, que conserva sus permisos. Para darlo de baja del todo:
kubectl --kubeconfig <kubeconfig-del-cluster> delete namespace kubelatch-system
kubectl --kubeconfig <kubeconfig-del-cluster> delete clusterroles,clusterrolebindings kubelatch-proxy kubelatch-reconciler
kubectl --kubeconfig <kubeconfig-del-cluster> delete validatingadmissionpolicybinding,validatingadmissionpolicy kubelatch-reconciler-jail
Borra la política kubelatch-reconciler-jail la última, cuando ya no esté el ClusterRole del reconciliador.
Si aplicaste la política de endurecimiento, bórrala también (no lleva las etiquetas de kubelatch):
kubectl --kubeconfig <kubeconfig-del-cluster> delete validatingadmissionpolicybinding,validatingadmissionpolicy kubelatch-bindings
Mover un cluster a otra instancia
Un cluster se registra en una sola instancia de kubelatch. La etiqueta KUBELATCH_INSTANCE_ID hace que cada instancia solo toque sus objetos. Para moverlo:
- Si aplicaste la política de endurecimiento, quita su binding: el bootstrap nuevo cambia la etiqueta de sus ClusterRoleBindings.
- Regístralo en la instancia nueva.
- Bórralo en la antigua. La limpieza solo retira los bindings y ClusterRoles etiquetados con la instancia antigua, pero devuelve
kubelatch-proxya la regla de solouids. - Pulsa «Reconciliar» en la instancia nueva justo después.
No sirve para compartir un cluster entre dos instancias a la vez, porque el bootstrap es un único juego por cluster.